C大调音阶在吉他指板上可以有不同的把位 https://www.zhihu.com/tardis/zm/art/496745355?source_id=1005
扫弦节奏型:1)下 下 下上 上下上下 下上
节拍
HUB GUITAR: https://hubguitar.com/zh_han/music-theory 指板: https://hubguitar.com/zh_han/fretboard
弹奏第一品位上的B弦,这就是 C音,一个以一定频率振动的音波。接下来你拨第十三品的同一根弦,同样地,它听上去好像是同一个音,但这个音高更高。这是因为声波的振动是原来的两倍之快,可以表达为1:2, 它们是有同一特性的音。如果两种不同的乐器同时弹奏C音,这个比例是1:1,这称为 同音。在下图中,第一品的音符将会是最左边的C,第十三品的音则是在最右边。所有在这两者之间的音符都是特定的音符,但一旦重新回到C音,就重新按照这个顺序继续下去。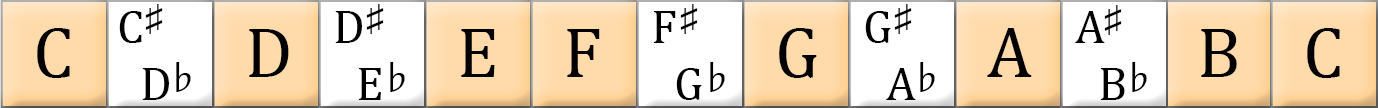
音程:就是两个音符之间的高低关系。在较低的一个 “C” 音和另一个较高的 “C” 音之间的音程就是 八度(八音音阶)。八度是音高的基本来源,其余的还包括将它分成更小的部分而得到的音高,称为 音数。半音就是移动一格,从 C 到 C♯。全音移动两格,从 C 到 D。 大多数现代音乐将八度分割为12级,如图所示,你可以按照这个音符的顺序来弹奏,从第一品的 B 弦开始,每次移动一个品位,直到第十三品,重新回到 C,一边弹奏一边大声说出这个音符的名字。所有这十二个音符一起组成了 半音音阶。音阶就是音符的顺序,并且没有重复的音符,所有的音符以升序,从低到高的顺序来弹奏。
根音?它就是一首歌的主调音,它是一个单音,其余的东西全在它的基础上变化,想像它是重力中心,它是一种吸引力,吸引着一首歌曲里其余所有的音,不管什么情况下都会回到根音上来。
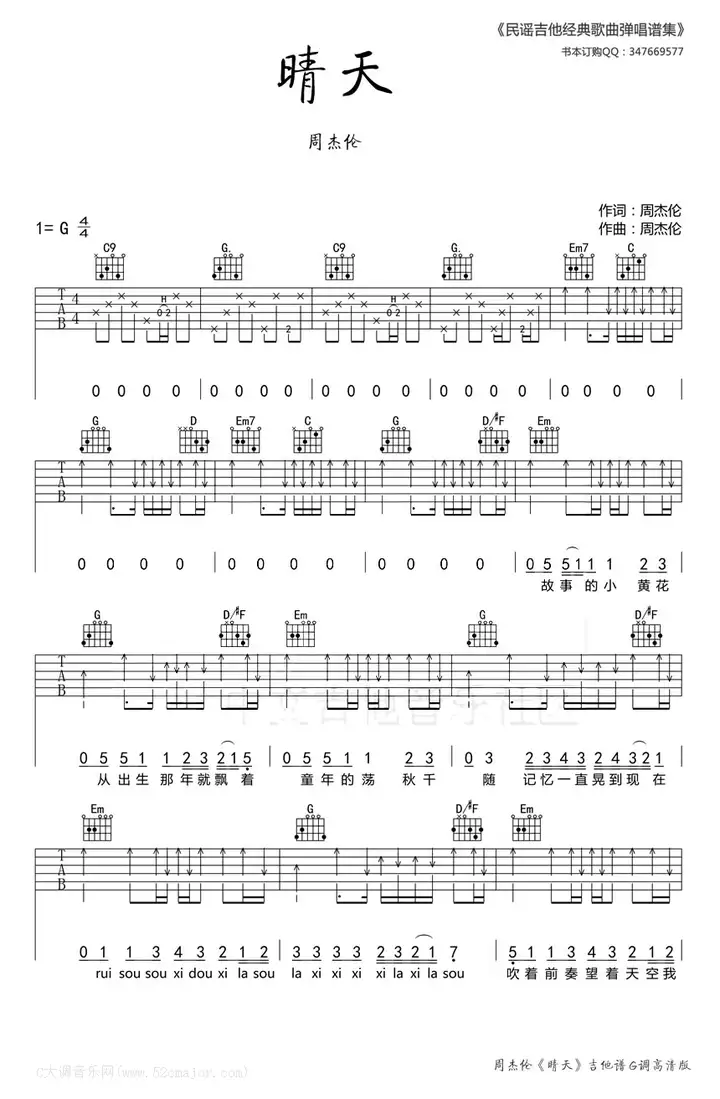
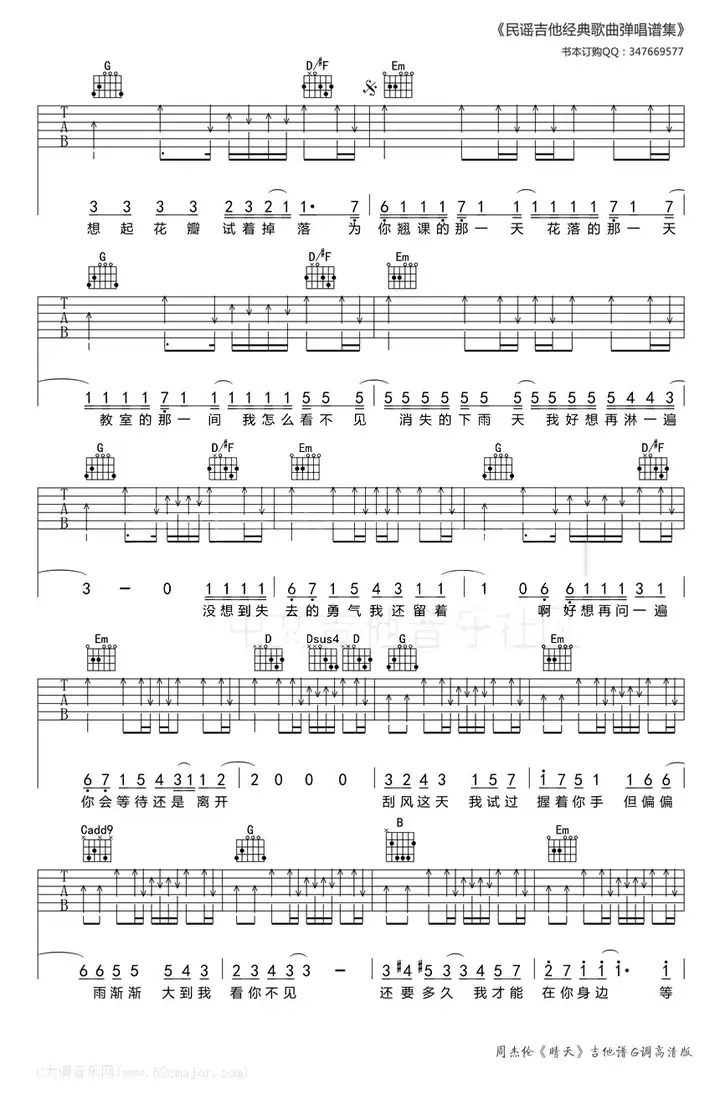
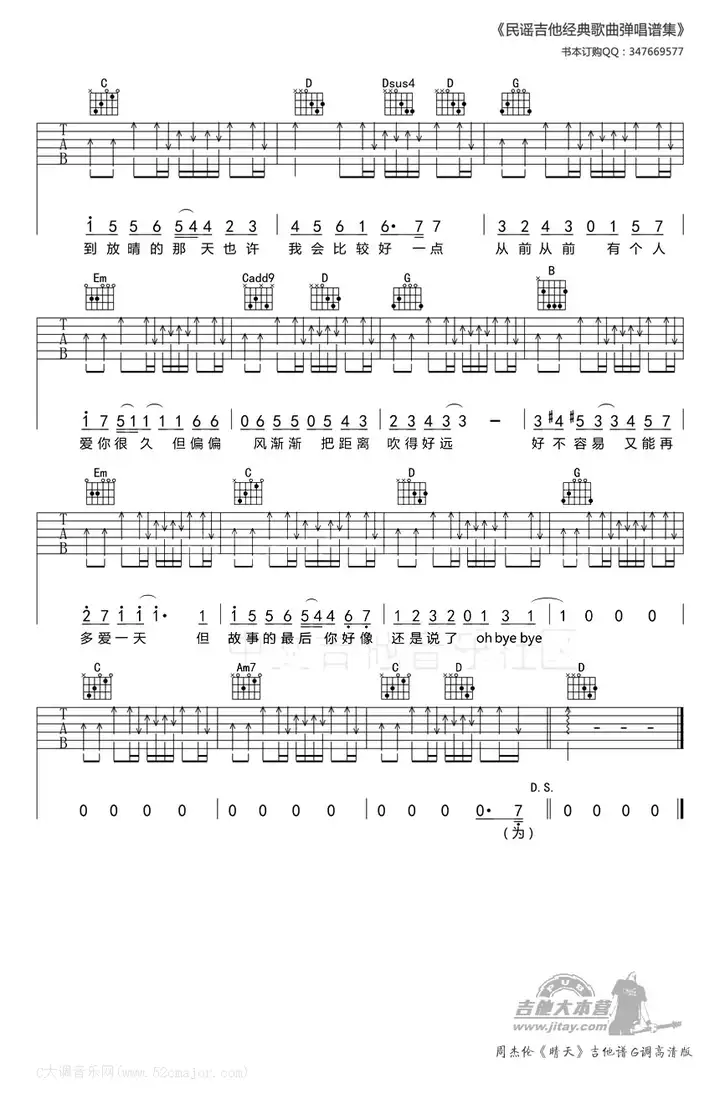
晴天 - 周杰倫
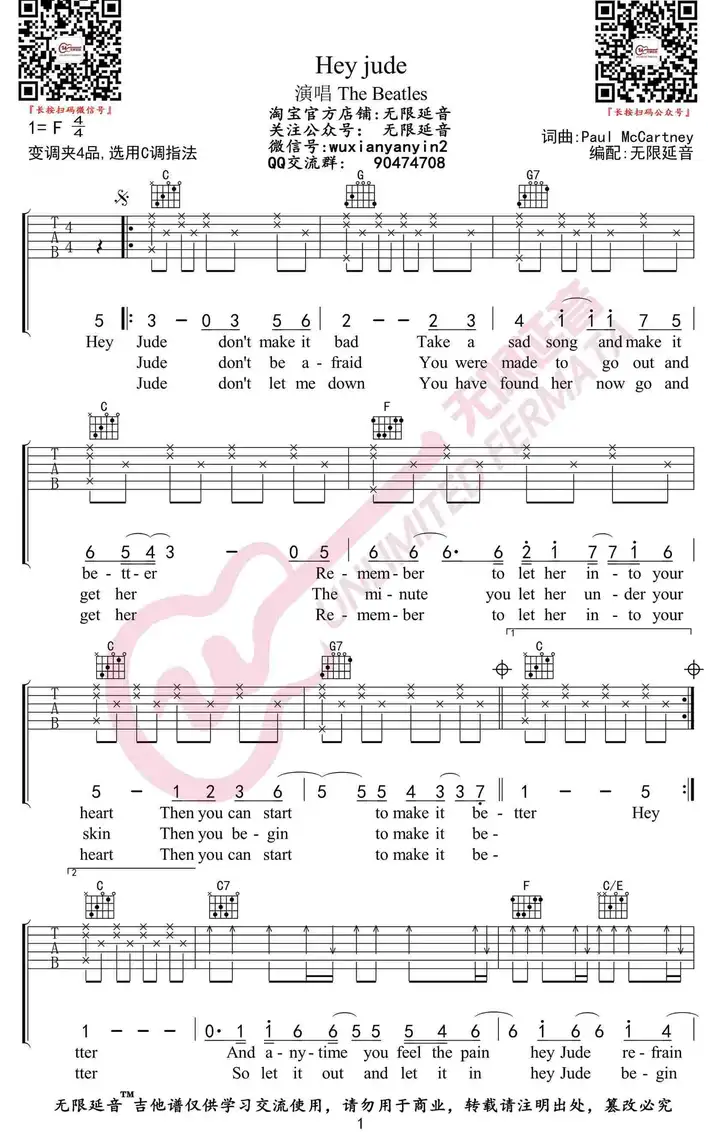
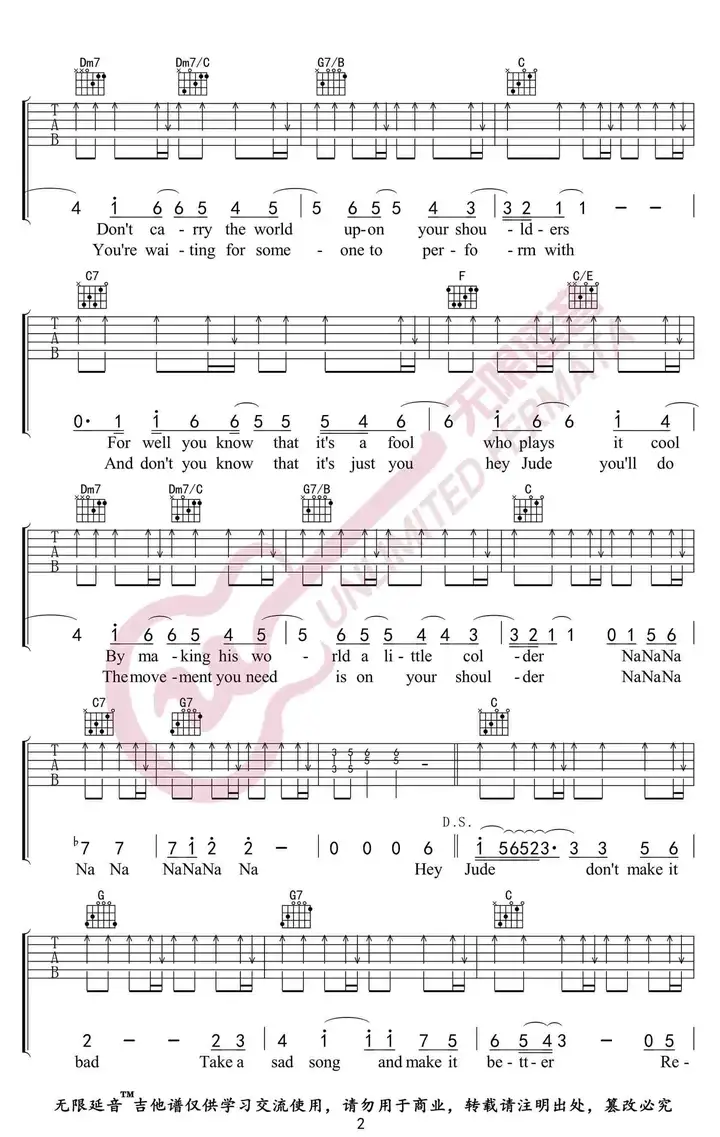

Hey Jude - The Beatles
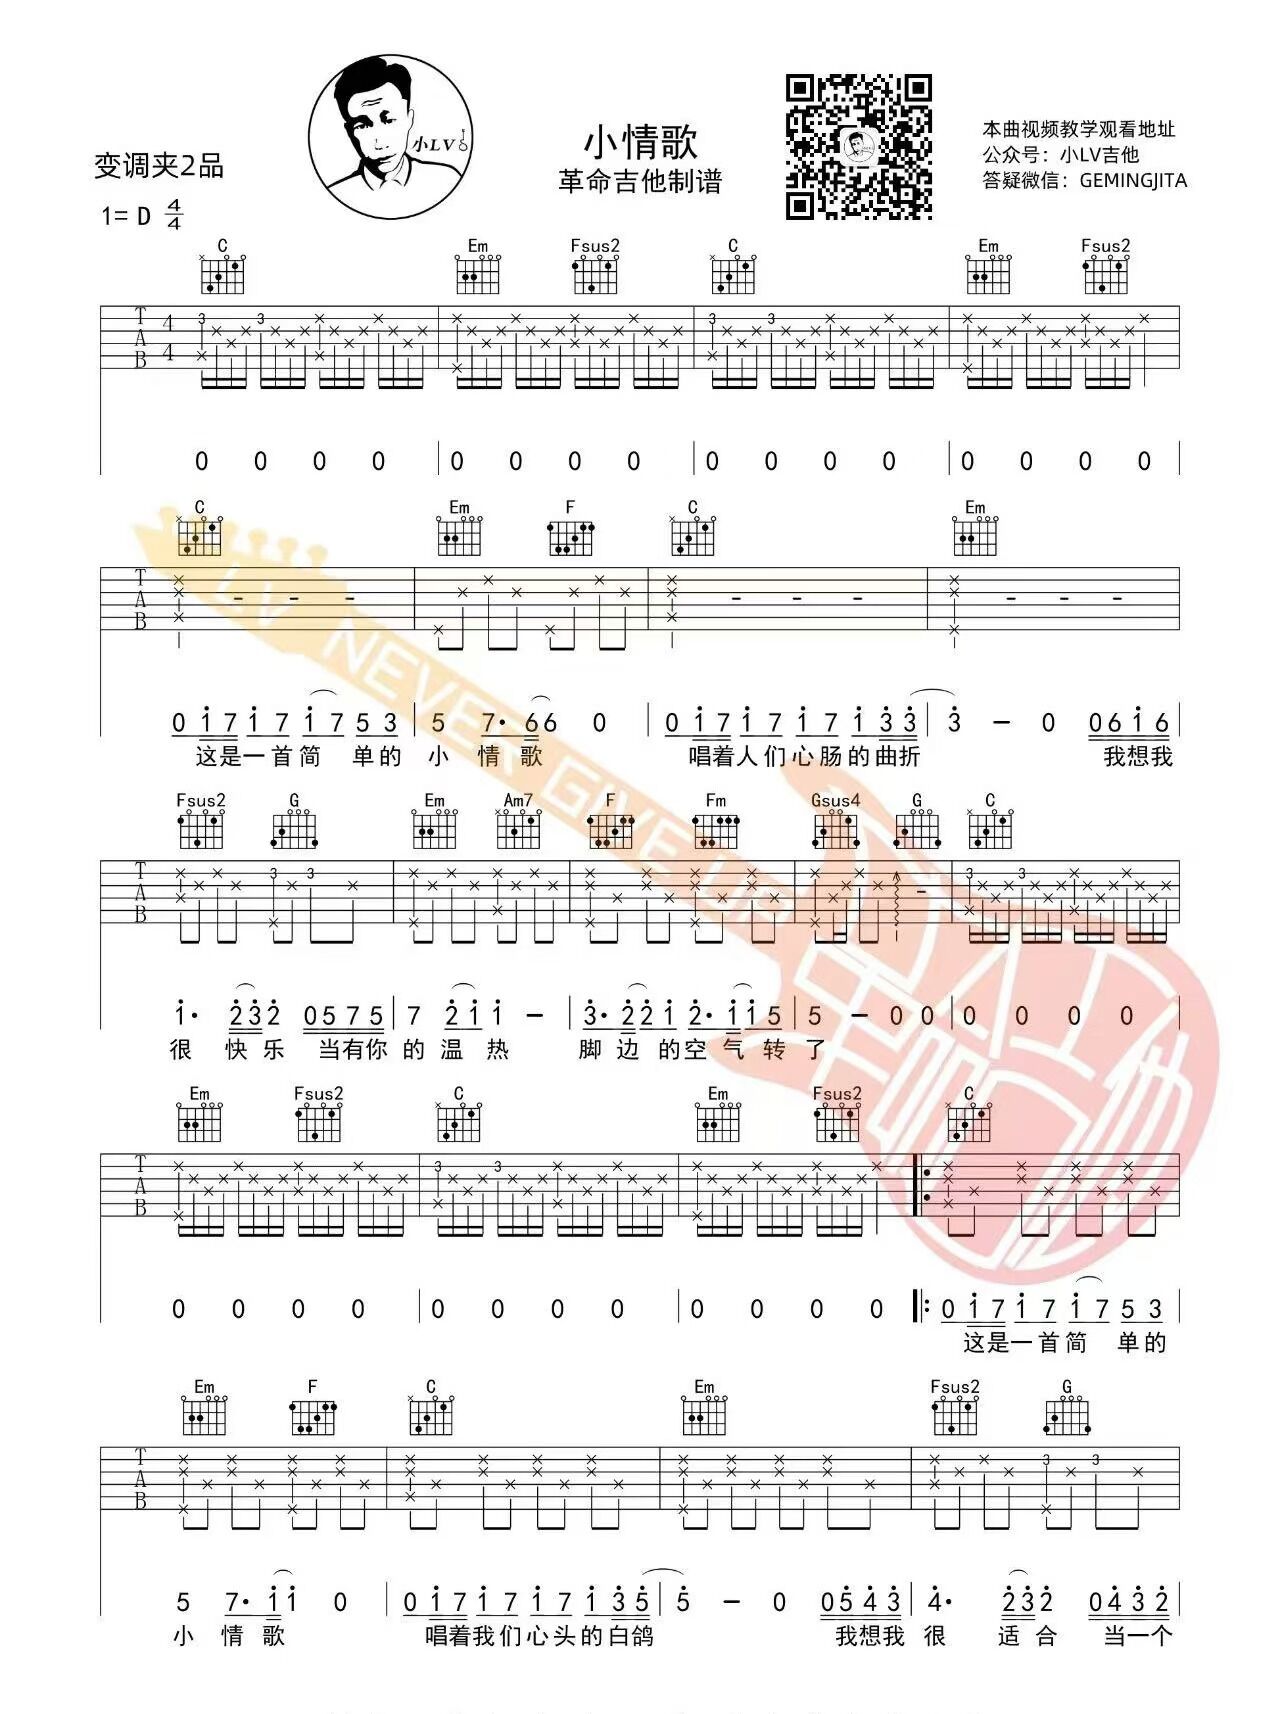

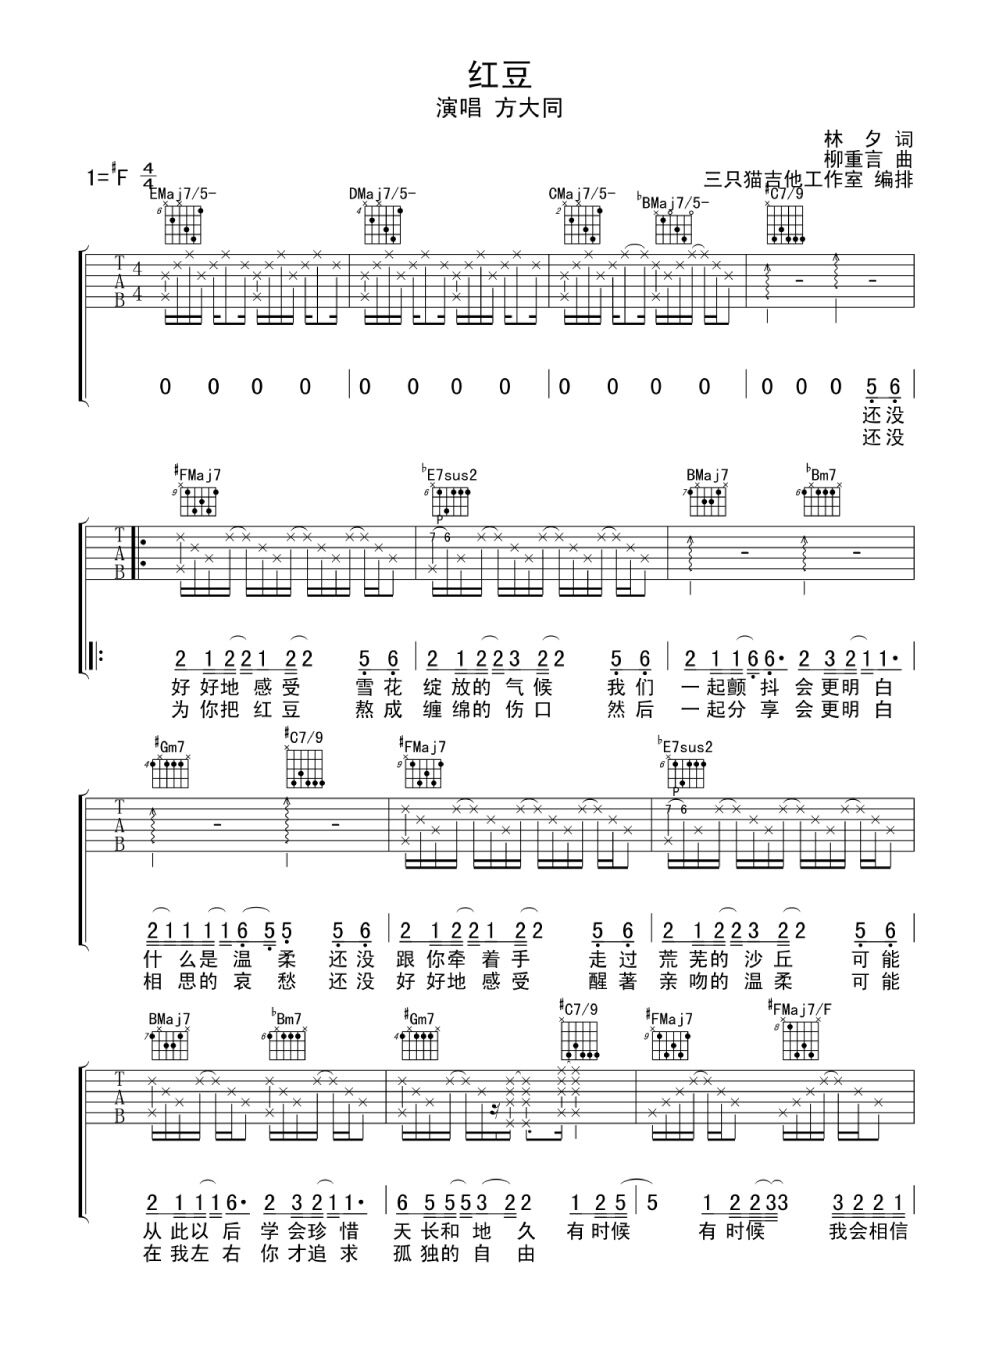
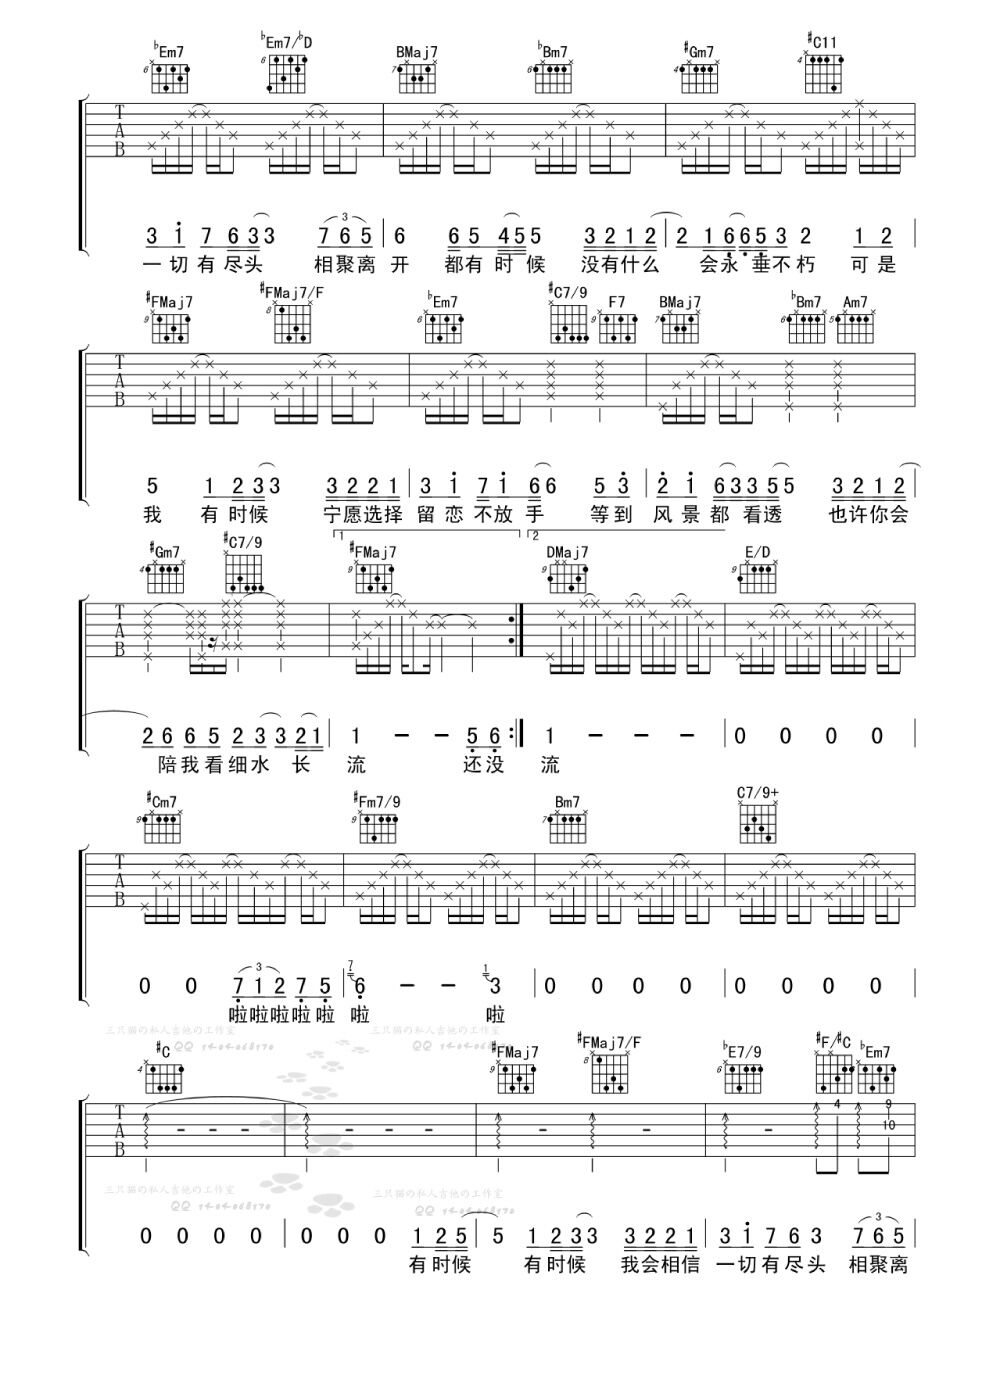
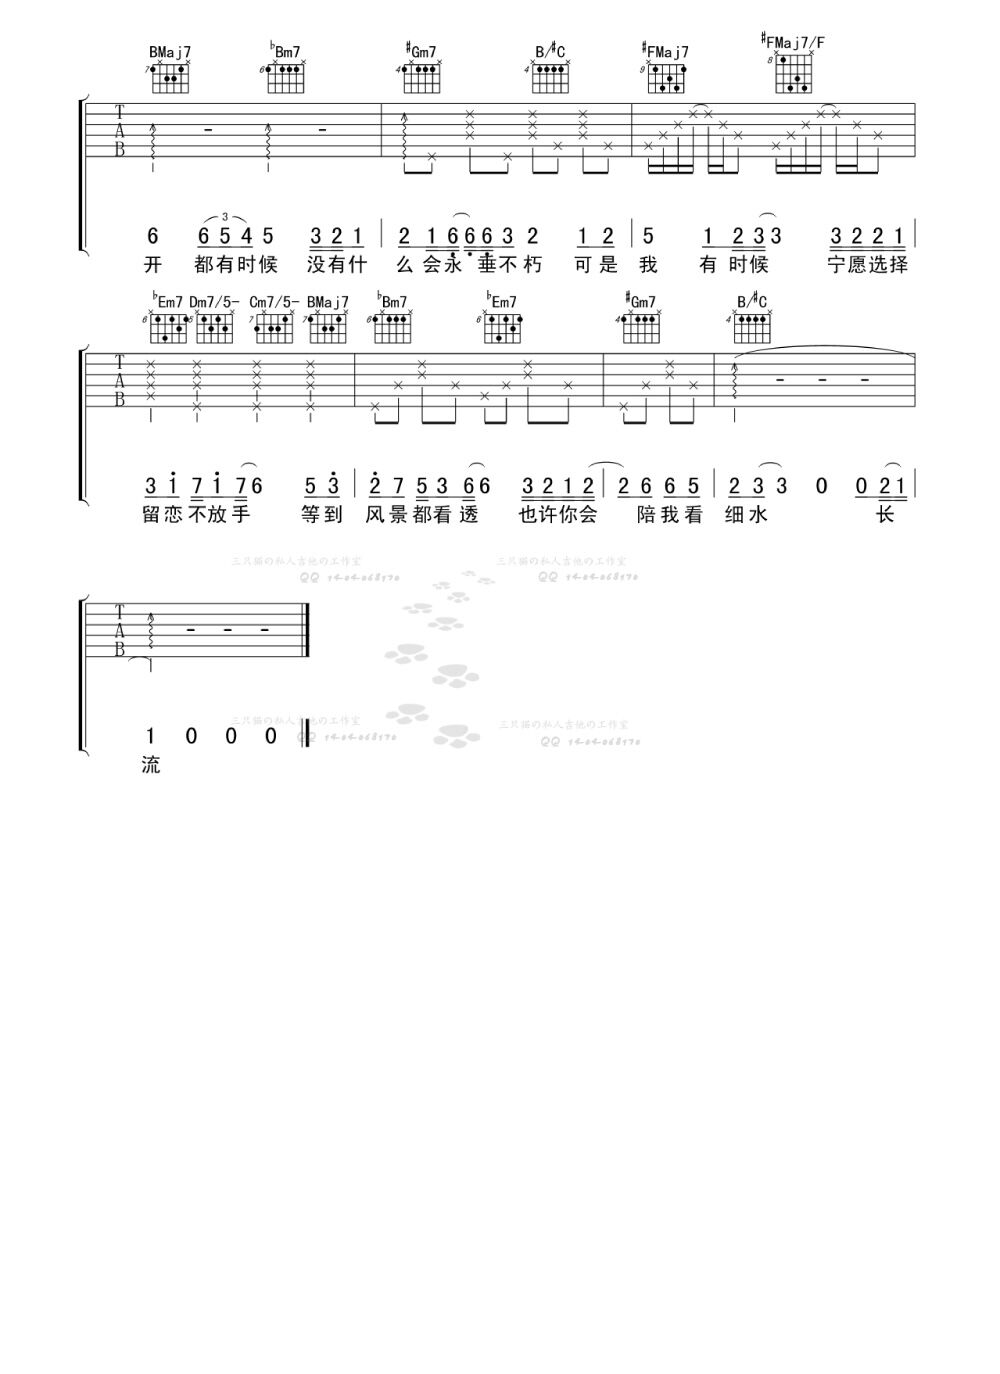
紅豆 - 方大同
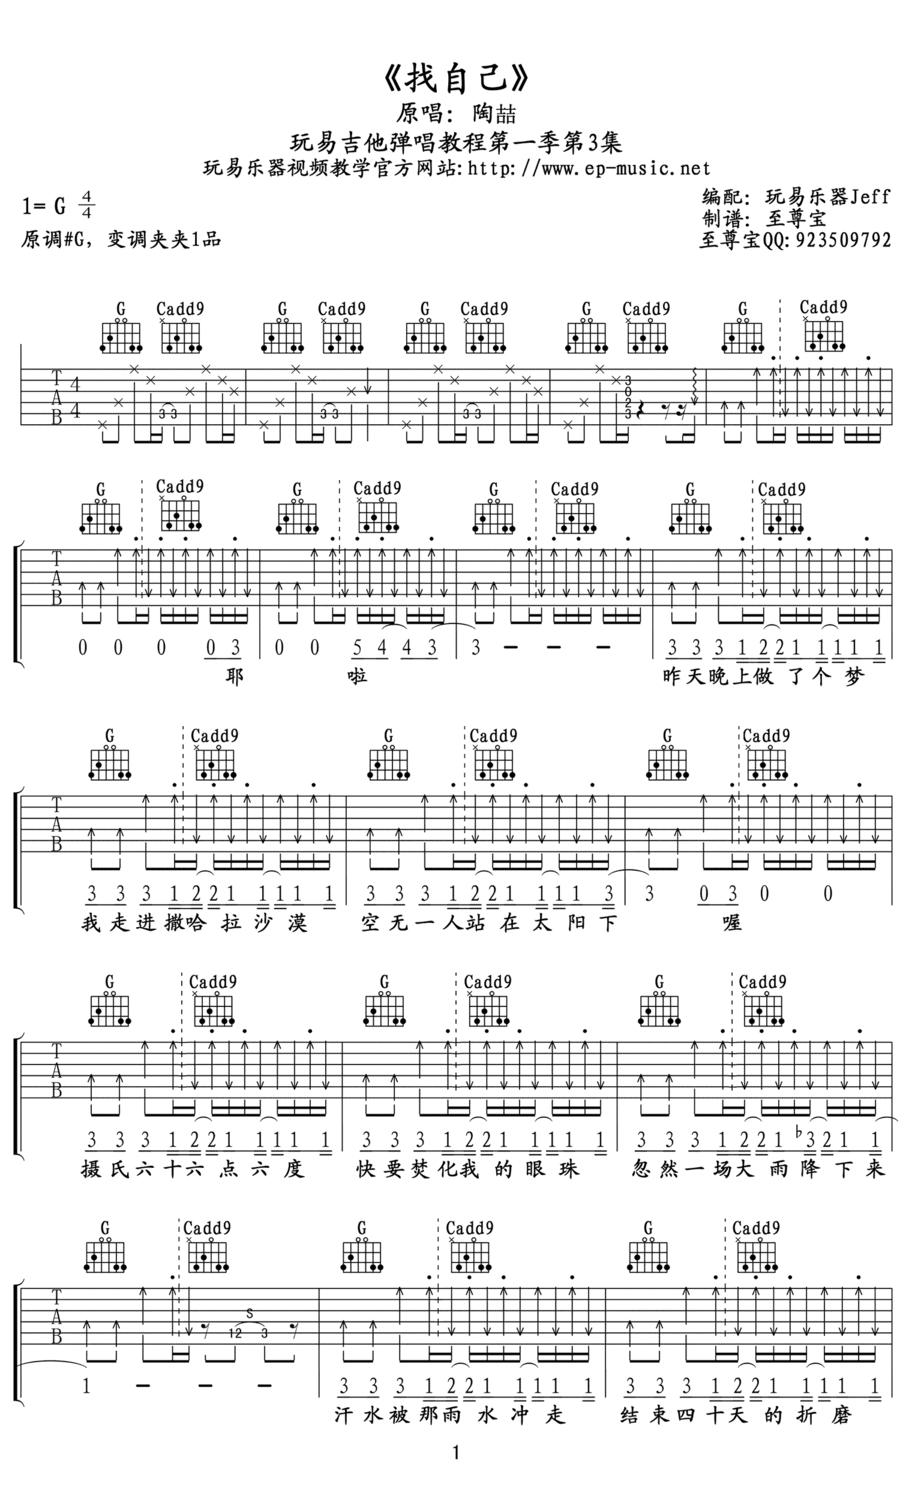
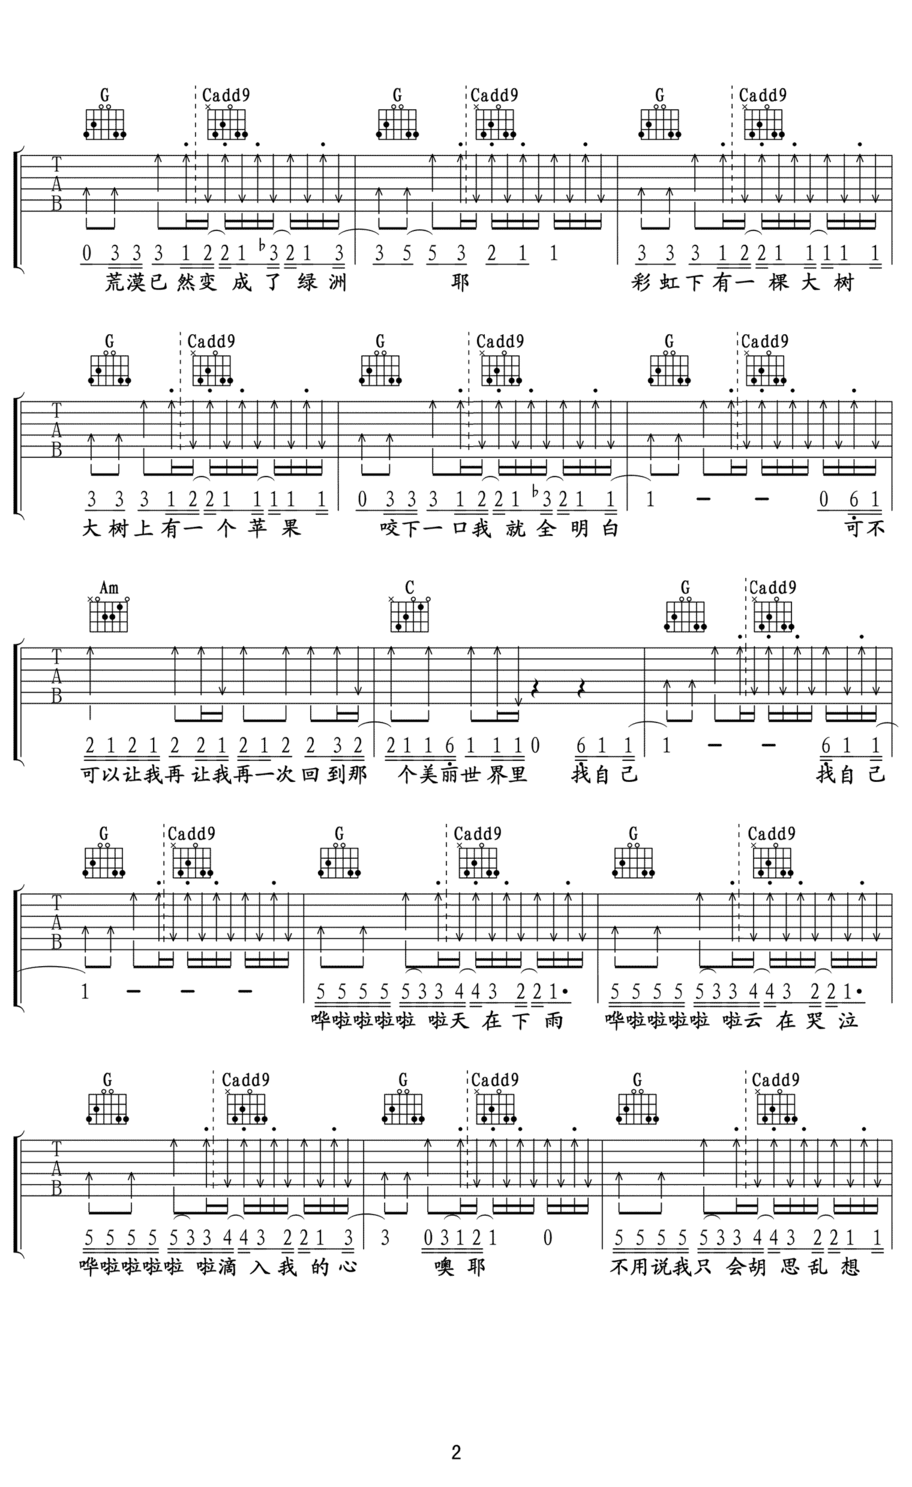
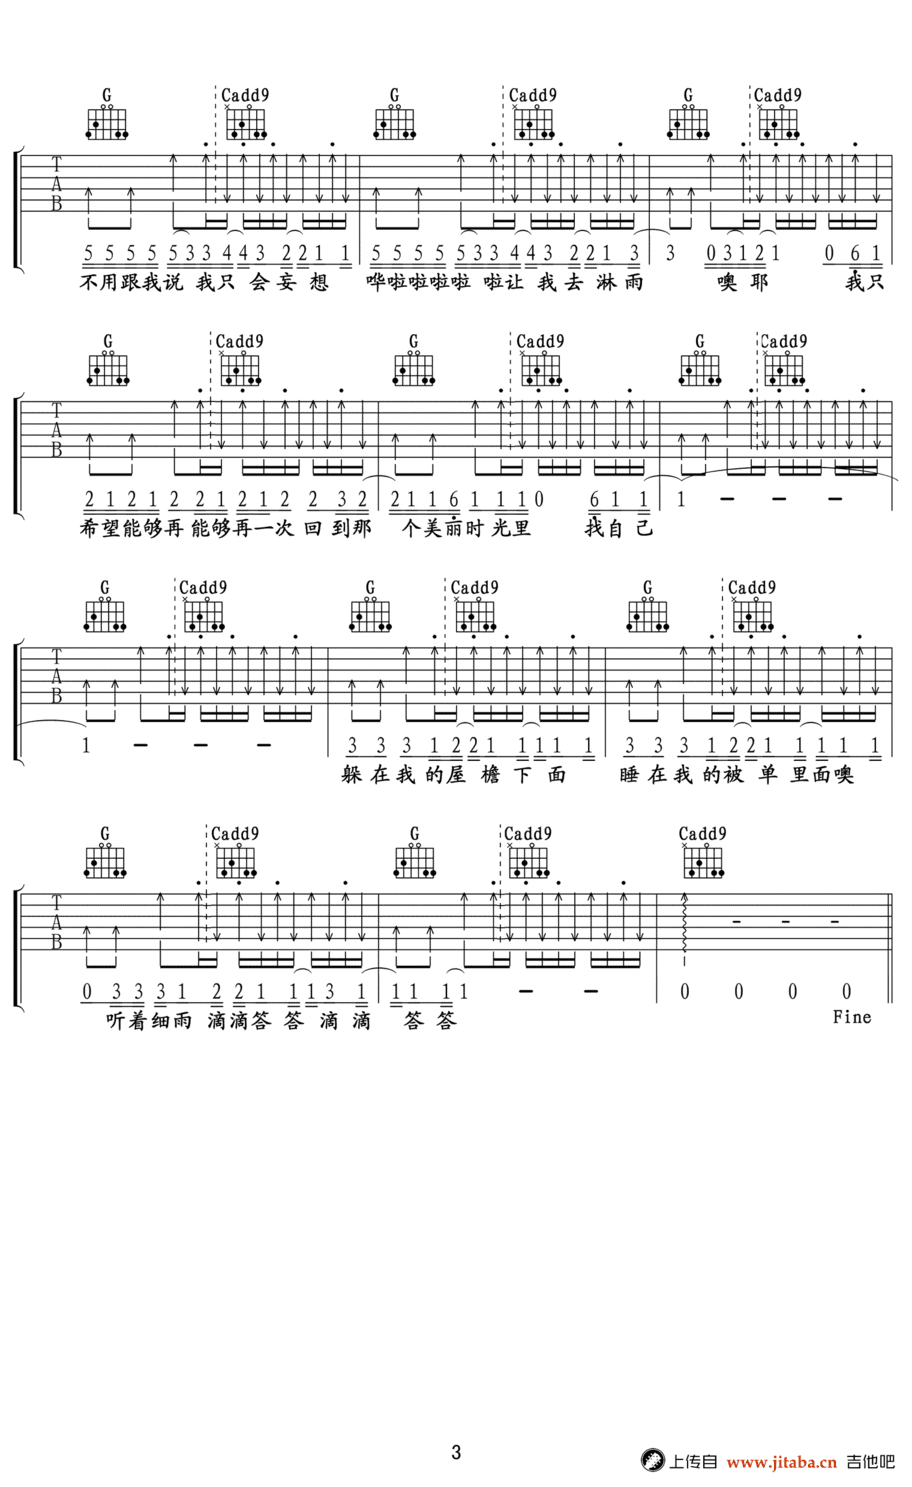
找自己 - 陶喆
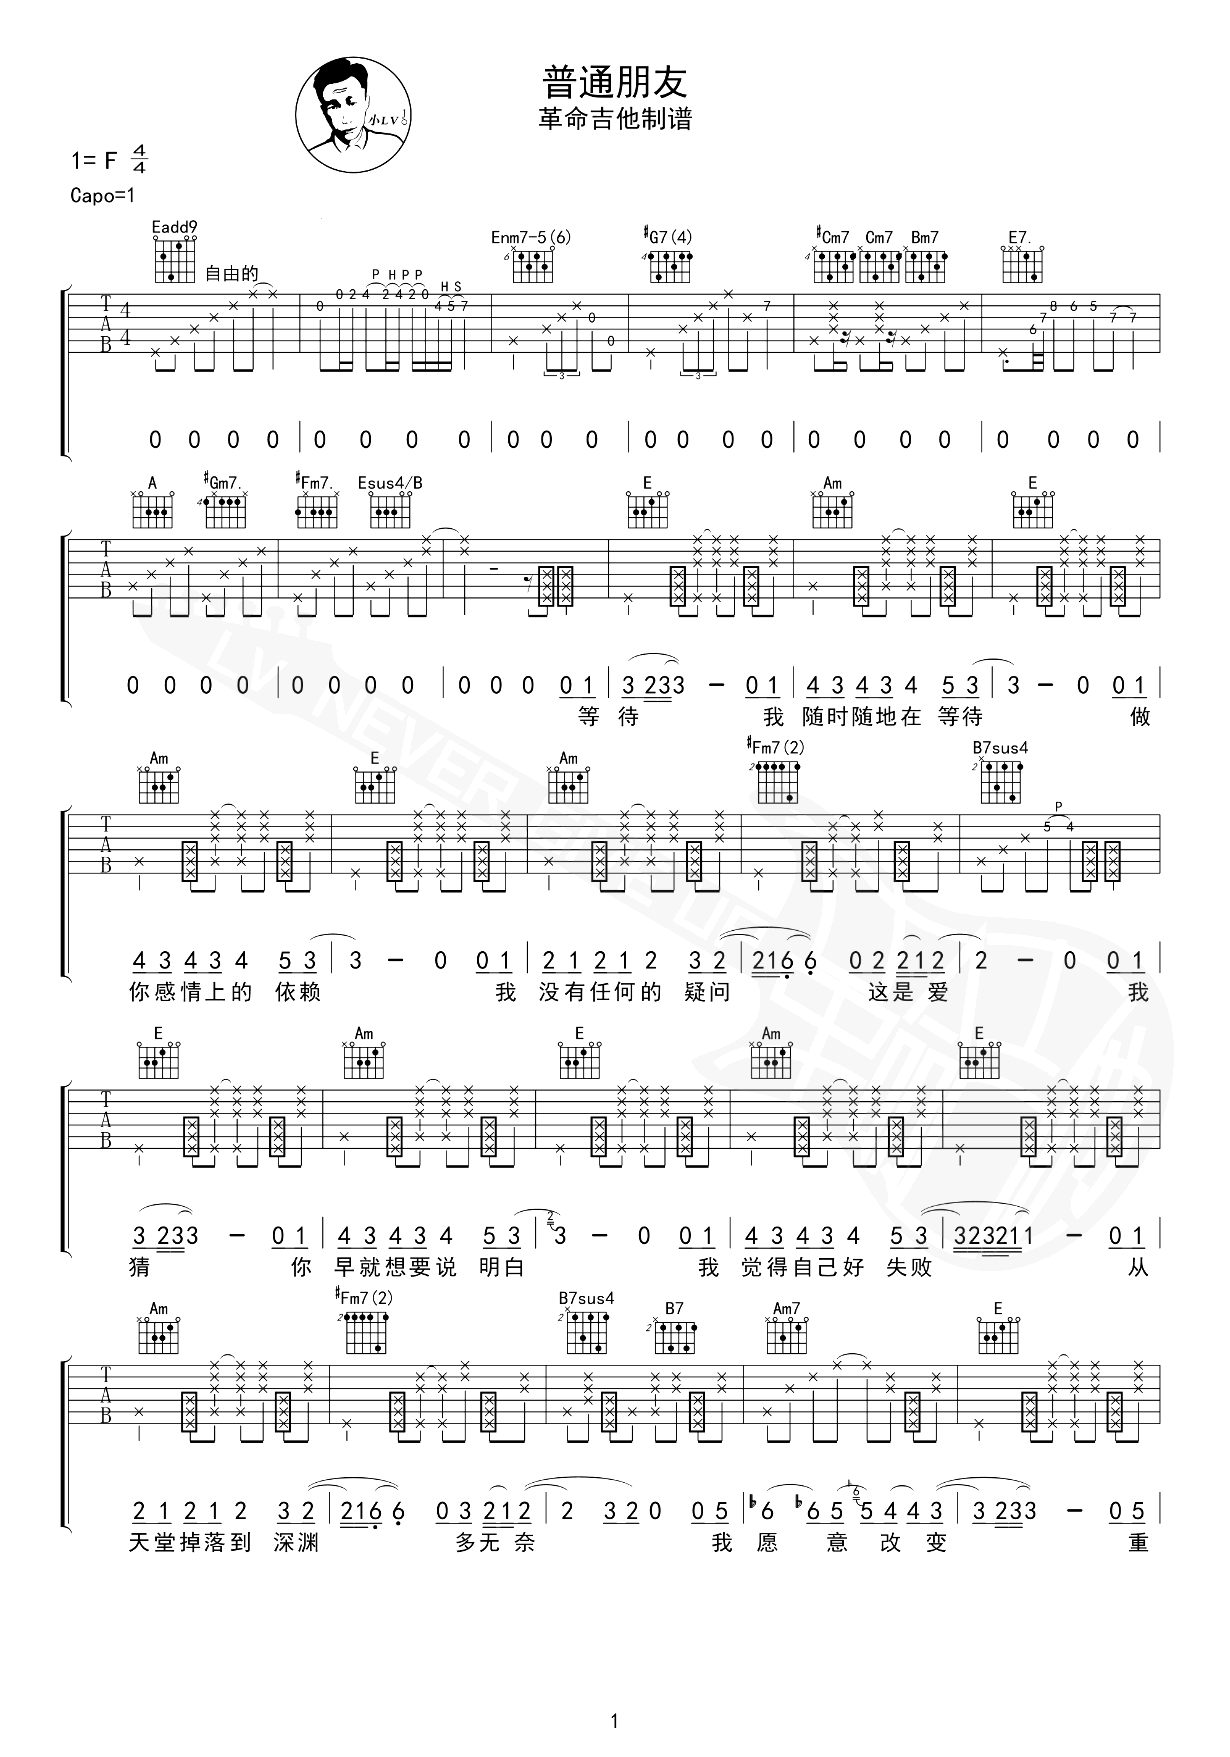
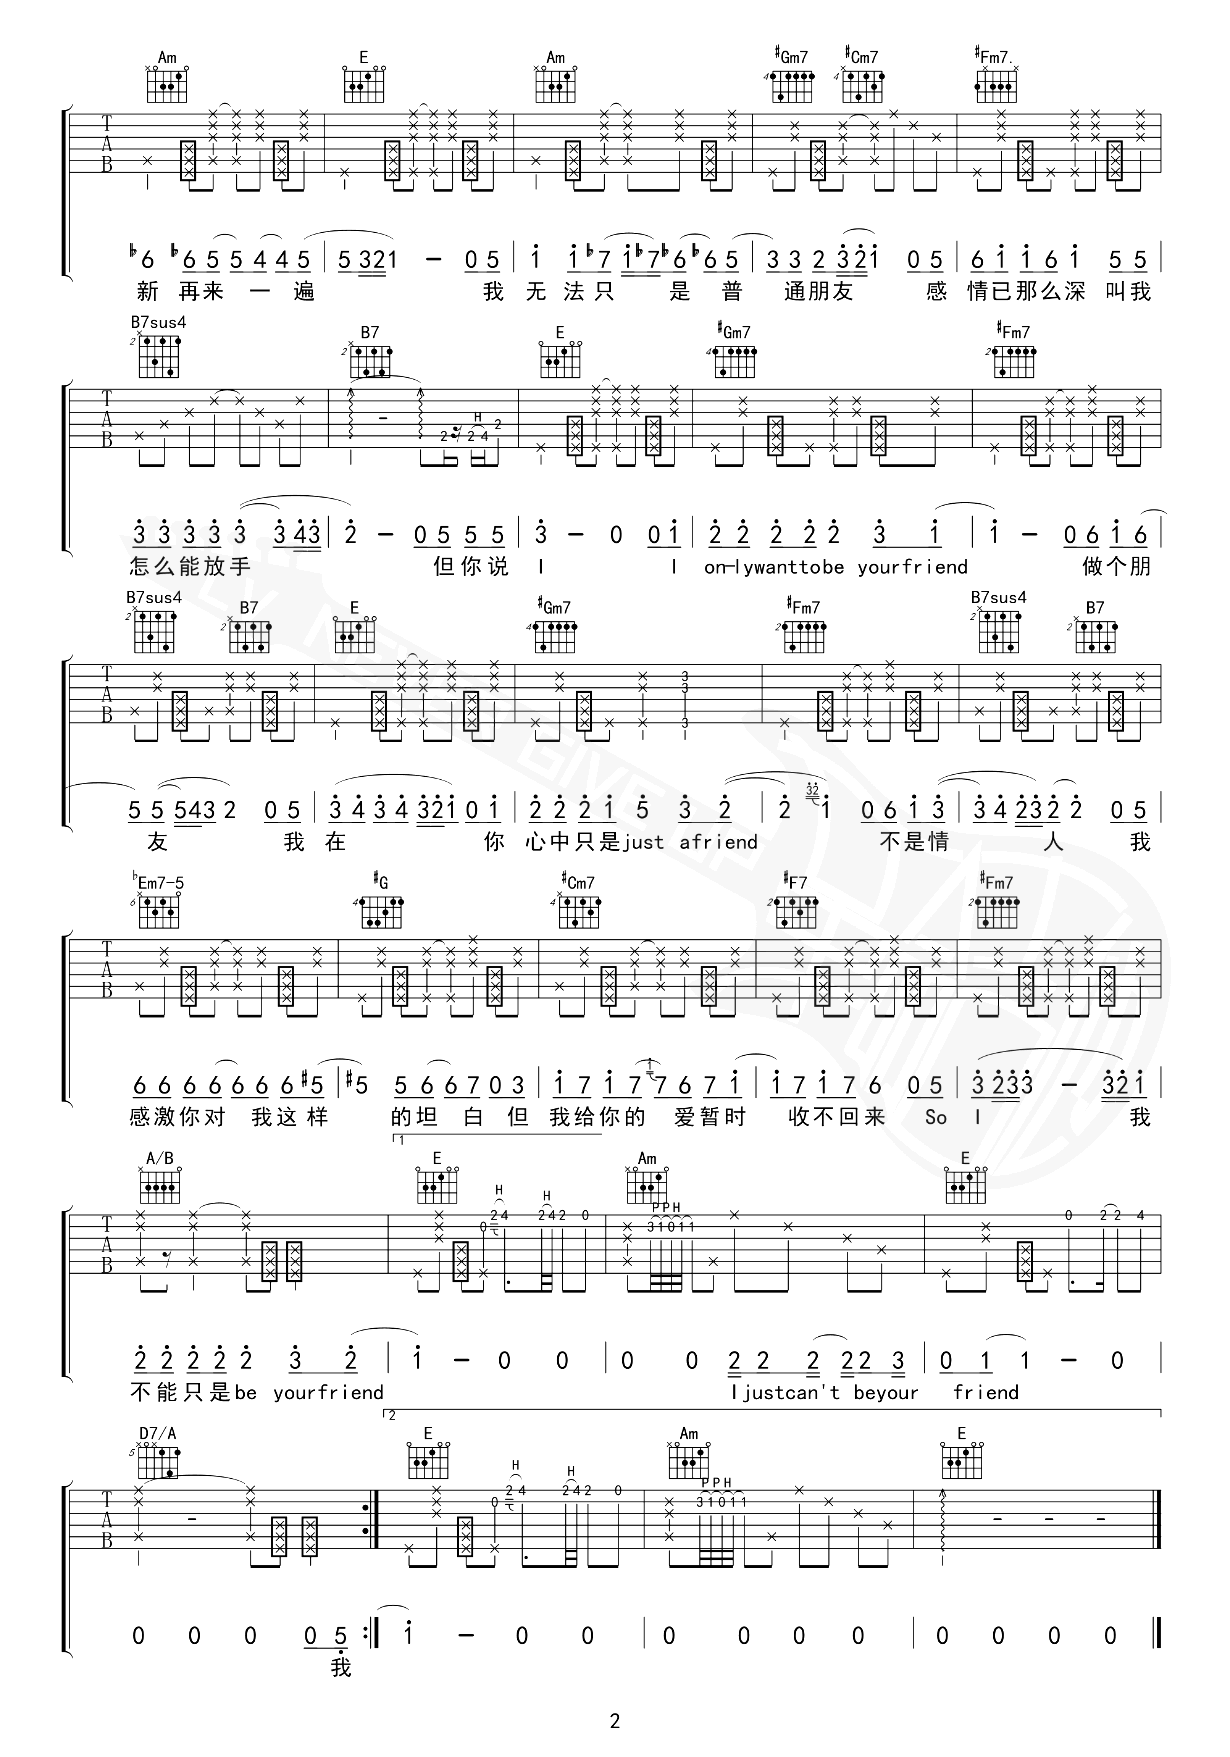
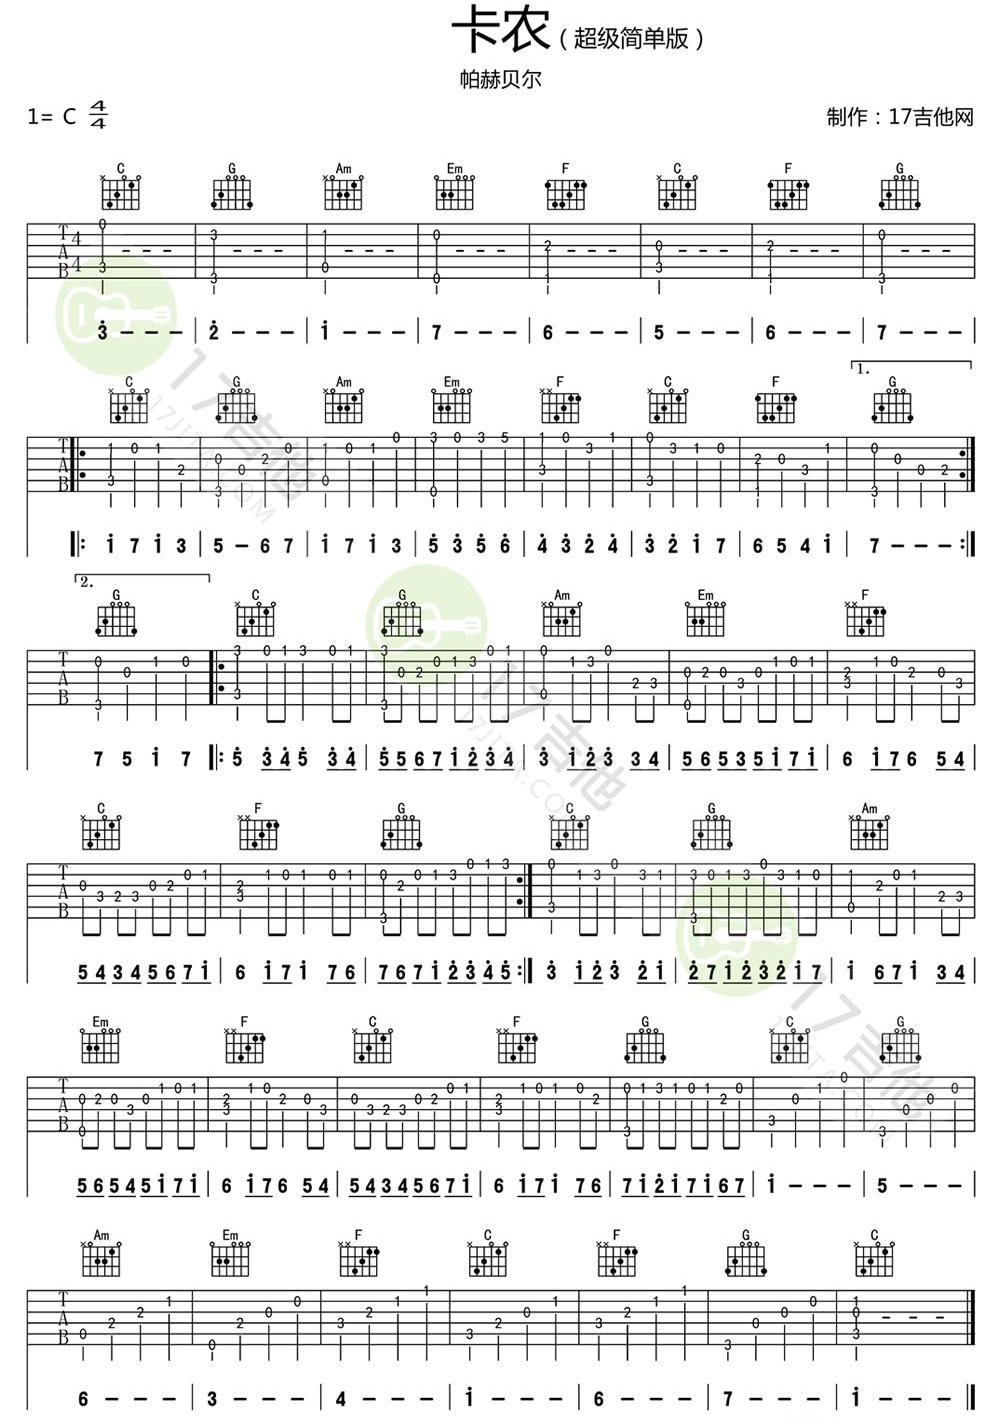
Canon in C https://www.bilibili.com/video/BV1if4y1A7SZ/
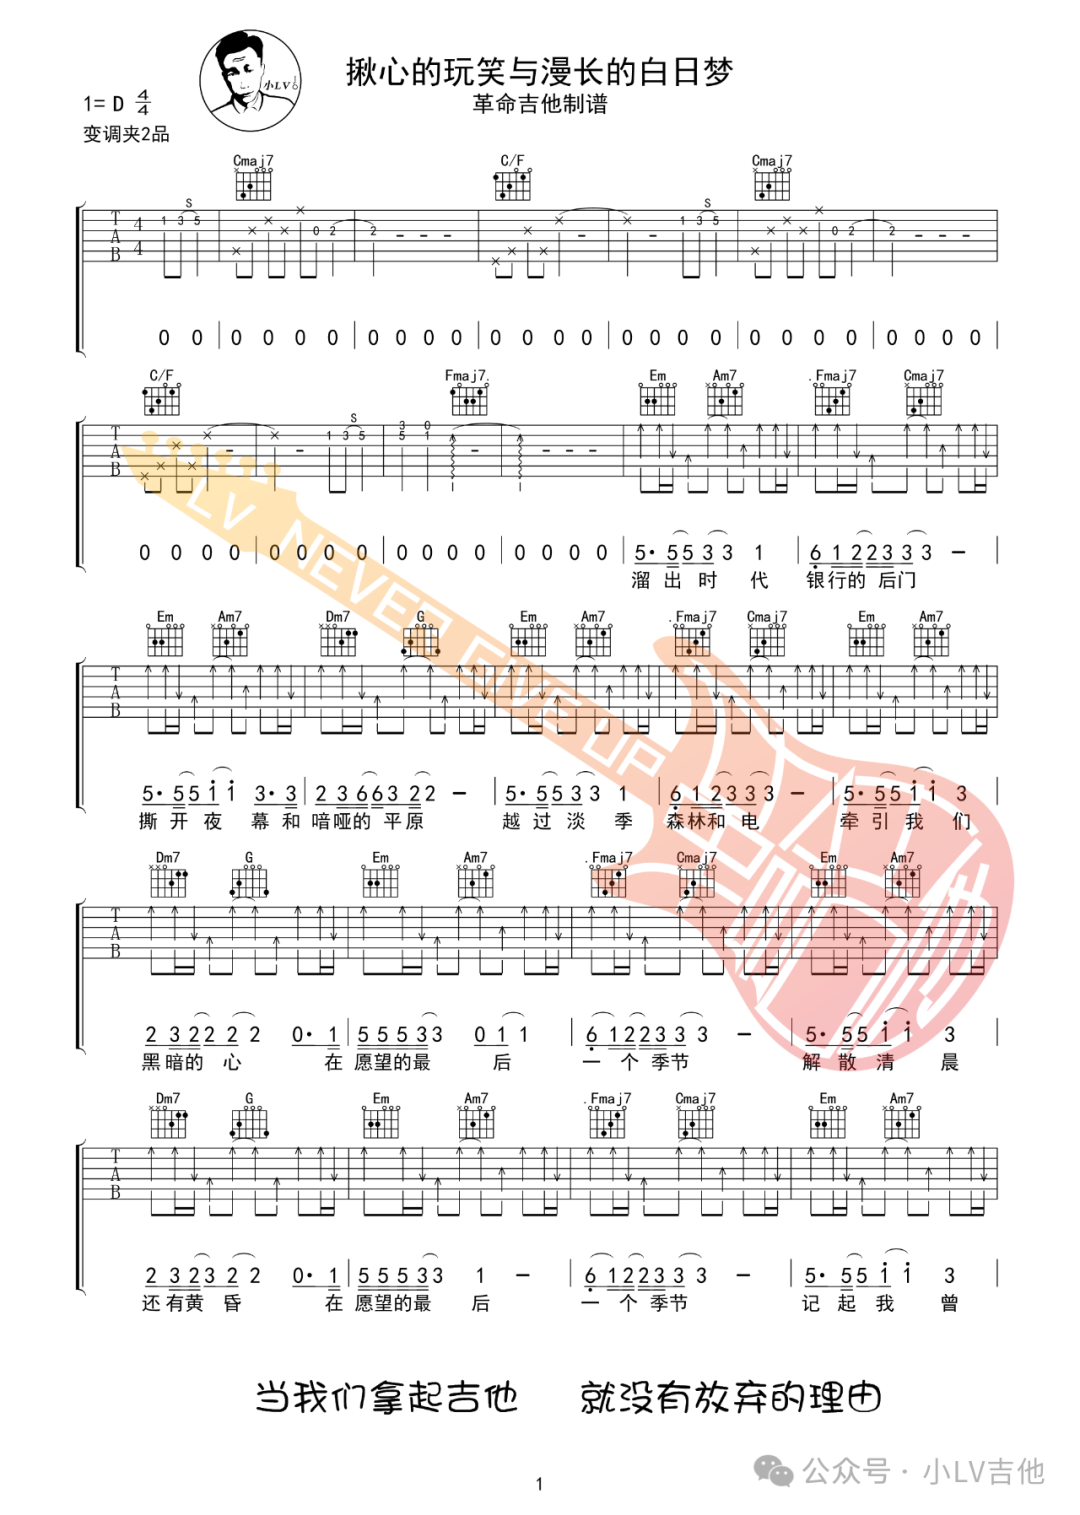

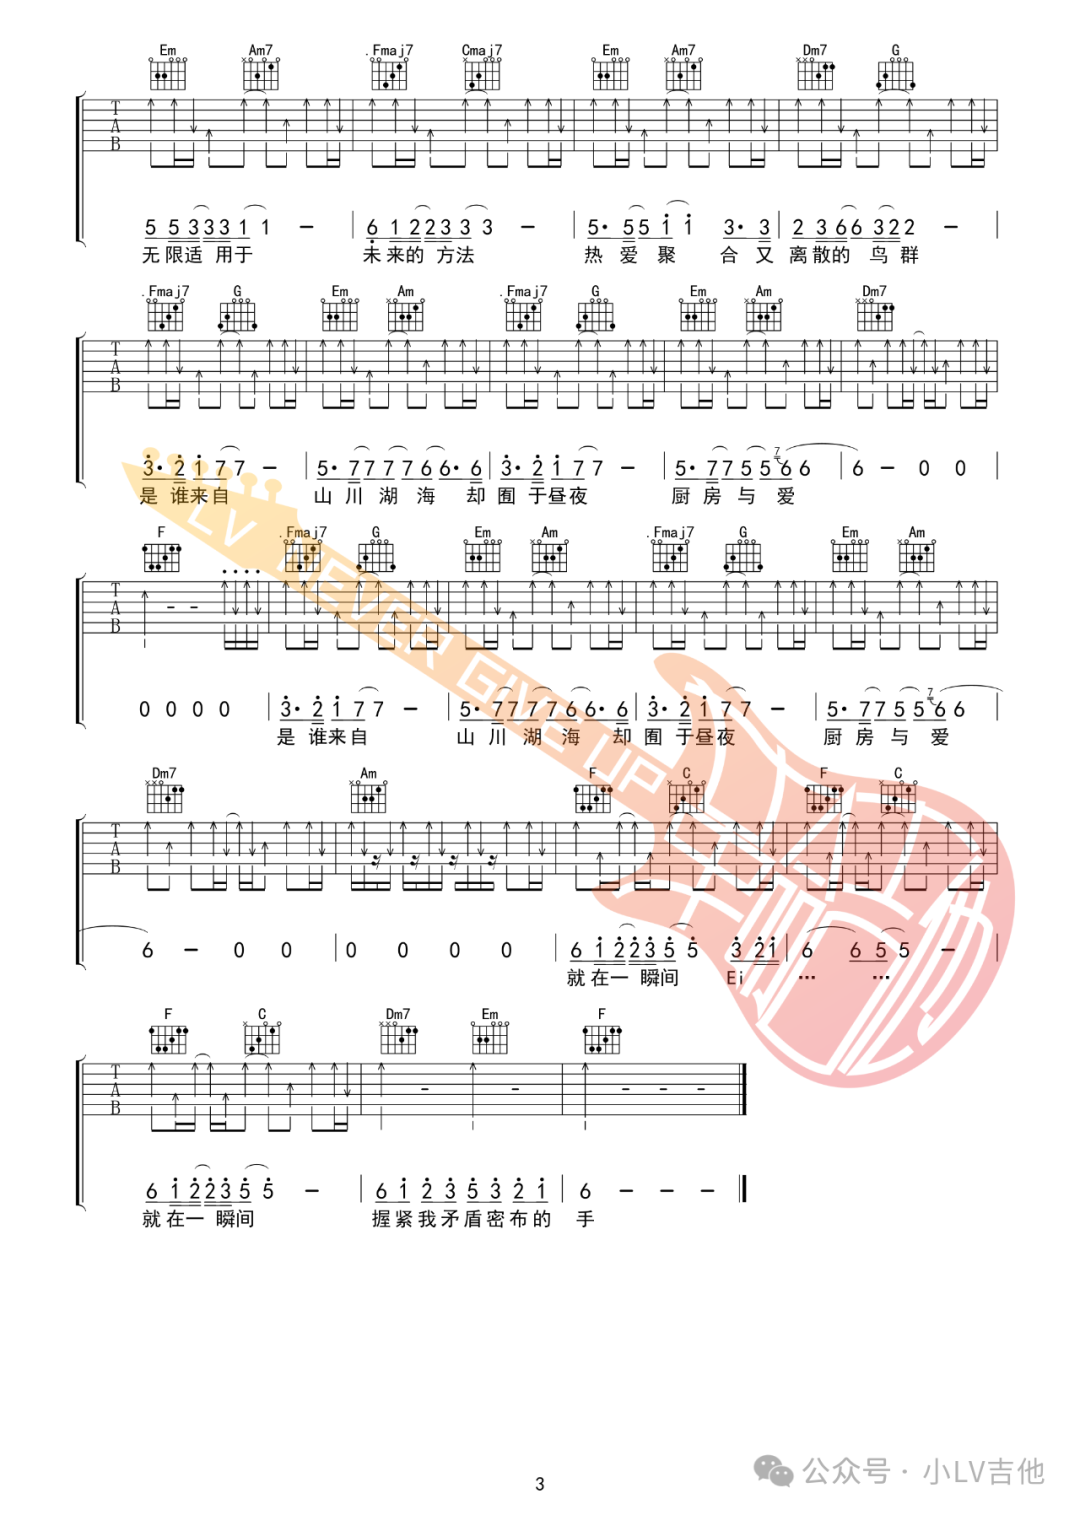
揪心的玩笑與漫長的白日夢 - 萬能青年旅店
https://www.bilibili.com/video/BV1cuHjetENY/?vd_source=ff210768dfaee27c0d74f9c8c50d7274
入职第一天,熟悉运维平台,目标实现其自动化,后续参与到美的云,?
熟悉新旧平台的功能和调用关系,拆分业务需求开发步骤,编写文档,每日汇报进展,熟悉开发流程、、
软工院作为非互联网公司的非核心业务的底层平台建设部门,结果导向,组员多一年社招;)无校招培养。?
EDP培训 + MGC(头脑风暴/产品调研/拉通对齐>>技术)
T型人才(广度+深度),开发技术+产品思维->架构师
不设限,主动承担任务,机会莫名来:) take other people’s jobs and become indispensable to the team..
复杂的事情简单化(思考简化),简单的事情复杂化(做到极致)
工作就是生活,生活就是工作,不需要平衡(找到热爱的工作)
成功的百分比 = 做事 / (个人 + 做事);做事的比例越大,成功的概率越大
Allen: 向上管理?× 向上反馈,同步进展
MGC结营
融入团队?主动承担?谈论未知?如何选择自己在团队中的角色,人设??
圈子
佛山校友会迎新
“努力会发光,先有为后有位”,“头三年不要动,把这一套学会”
程序员的本质核心竞争力是什么?1.开发都是那一套 2.专精一个领域 3.meet新公司的需求 4.解决问题的能力
华为云主机开/关机/重启自动化 : mq、定时任务、公有云api、crud、、
完成第一版8.14,自测8.15,,merge request,code review,sit,测试,uat,发版8.22、、
反思、、在开发同事的指导下完成了开发,不具备独立调研和开发能力,,
缺少对产品的思考??没有对需求进行120%的思考和完成。。
顺德校友会迎新
why Midea?1.生活成本低(特别是住宿好通勤方便)2.相比下工作轻松(能够有自己的时间学习业务以外的东西)
思考自己在..年后会到什么层次(本科毕业+6y ?= 博士毕业起步)。。阶段性目标
深入一个领域,,
先做一点功能点,然后负责一个模块,到不同系统的交互、、
多学基础,与外包的区别。。与人沟通的能力
幂等,整体设计,微服务治理,看项目源码,,
干半年就不是应届生了。社会很残酷,前两年要快速成长;思考两/五年后的情况、、
开发整个过一遍,打包,发版,,
多讨论,多问,code review
失败邮件发送:设计一个功能,,关注点,逻辑路径,通用性,,如何表述。。?! –>
方法:事务+行锁【悲观锁】,避免在高并发场景下先读后写导致多个线程同时读取相同的值然后同时写入引发数据不一致的问题
测试:线程池多线程访问,打印数据,排查重复值;考虑数据库连接池配置
思考:项目部署到多节点下,则是多进程的多线程环境,需要用Redis分布式锁,或者唯一的全局数据库节点加锁;
单节点的多线程才能用synchronized?、
1 |
|
1 |
|
优势:完全避免了并发更新导致的数据不一致,是标准的悲观锁实现。
潜在问题:如果方法被高频调用,FOR UPDATE可能导致锁竞争,影响并发性能。
更优方案:直接 UPDATE + SELECT
Azure公有云主机申请 :根据云管界面配置配齐参数发送报文到作业平台,完成自动化主机创建和标准化
对其参数,连续加班,9.9完成第一版,9.10上sit前端联调,9.11开发部分发邮件,9.12上uat,6.同步DDL&DML,7.发版,验收成功
接触运维协同,,code review,联调,,集成,部署,流水线,,
窝囊费:)到账
Azure公有云主机回收/开/关机/重启 : 调研AzureApi和测试方法,开发,,
9.23回收上sit,9.24开关机重启代码重构(原华为云方法过于不通用),9.25bug毁了我的足球梦,9.26配置ngix上uat,验收
思考:自测可以 1.全流程验证 2.单独功能验证 3.考虑开发与测试环境的区别(ping的包装方法/命令行执行在开发/测试环境的区别)
后续:完善公有云开发(Azure回收配额,ip,失败邮件),后续由运维平台MOPS -> 参与到数据库开发
任务触发式失败邮件完成,改造为工单定时任务扫描式,10.17上线
邮件通用性??工单+定时任务层面的通用,,
数据管控平台DataMars: 云管cmcloud开发功能,先提供内部服务,后到SAAS,,
InfluxDB备份恢复 1 调研 2 手工实现 3 详细文档
2-3月时间,不要求11月上线,整体设计,转正答辩
api,数据库内核,容器,k8s
容器,登录主机,查看docker实例,操作数据库实例
1 | ~$ sudo su - apps |
influxdb 命名空间下的所有 Stateful、Pod 的状态和节点信息1 | kubectl get sts -n influxdb |
influxdb 命名空间下的 service 信息。1 | kubectl get svc -n influxdb |
kubectl exec 进入指定的 Pod(默认进入其中的第一个容器),并启动一个 bash shell;可以看到当前 InfluxDB 版本是v1.8.10-c1.1.21 | apps@(datamars)mhpl74337-10.20.248.65 ~$ kubectl exec -it influxdb-e2cb6c913a191e56c134e-data-0 -n influxdb -- bash |
1 | root@influxdb-e2cb6c913a191e56c134e-data-0:/# influx |
1 | root@influxdb-e2cb6c913a191e56c134e-data-0:/# influx_inspect export -datadir "/var/lib/influxdb/data" -waldir "/var/lib/influxdb/wal" -out "influxdb_test01_dump_out" -database "test01" -start "2024-10-22T00:00:00Z" |
1 | sudo kubectl cp influxdb/influxdb-e2cb6c913a191e56c134e-data-1:/influxdb_test01_dump_out data/influxdb_test01_dump_out |
1 | kubectl get secrets -n influxdb # 看命名空间 |
1 | root@influxdb-e73f149ff7192bd87d190-data-1:/# influx -import -path='influxdb_test01_dump_out' -precision=ns -username='admin' -password='' |
-database,把influxdb集群实例中所有数据库的数据导出,加 -compress 导出压缩文件-compressed 导入压缩文件,本质上是先解压后倒入10.14-10.18:看文档,建立InfluxDB集群概念(前期已经也在看了..),建立整体框架概念(apiserver–bakserver–agent)
10.21-10.25:本地容器搭建influxdb集群×,连接服务器测试实例验证功能,了解K8S概念,手动验证实例(库级)导入导出即逻辑备份
10.28-11.01:对其需求(能做但没用户??),完成技术文档框架,开始将功能接入datamars-bakserver,了解golang开发
11.04-11.08:搭建go开发和agent项目环境,,无法理解go项目结构,尝试从bakserver侧理解task下发-接收-执行全流程
11.11:理解所有业务代码(after2weeks)发现task下发无需改动,只需适配influxdb(修改配置类和表),接着打包至sit环境打印log调试
11.12-11.15:研究pod添加container(改sts后delete pod重建),go项目构建(windows尝试配齐开发工具但有些包依赖linux环境)》。
11.18-11.27:本机wsl的ubuntu成功构建起datamars-agent,边抄边做,不用理解其框架?.. 及时请教专家
11.28-12.03:kun手改agent代码:)打包image push到dockerhub,宿主机拉取镜像后本地grpcurl调试 pod ip:port 验证功能
12.04-12.09:bakserver打日志流水线部署到uat(集群实例所在环境),通过apiserver-bakserver-agent中的日志验证全流程功能
12.10:验证通过
技术文档先行,将需求拆分成一步步,重要的是要有产出,,能汇报进度。。buffer。。好心态😇不怕叼
关注重要的事情(功能接入已有框架/理解业务逻辑×,功能验证和对齐需求√,开发卡点及时请教)
1/2时间幻想(串联已知信息且验证,对齐上下游并重复验证,本质是开发环境,业务不熟悉),1/4等回复(线上下请教+准备),1/4开发(快乐短暂)
与人沟通是重要的能力。。拉群问。。软件开发还是很残酷的。。
2025.04:重新考虑… 1 influx_inspect export只是把该pod指定数据库(或所有库)的指定时间段的分片数据(tsm&wal)导出line protocol文件,各Data-Pod数据不一致时不能代表整个实例;2 influx -import本质是将数据重新写入,前提要先恢复好shard元数据,,
1.02:不上心
1.14:开发uat自测(sit没测)完成,开发分支合dev提测,最后合main上线
1.16:SD/GA测试发版失败,恢复工作流需要人工介入验证,存在问题 1地址没有动态配置!! 2漏配接口/审批流变更
1.21:发布修复版本,生产延后
当前阶段的关键,,交付能力,,工程能力是练出来的
熬夜是没有对明天的期待、、-》培养兴趣转移注意力、,books
程序员。技术。不要只看自己的一亩三分地。。开源项目
工作以外;:给自己创造需求,根据需求解决问题,在解决问题上配合看书,,从而在某一细分领域有知识图谱,有一技之长,用系统性的看书代替cdsn查找零散的解决方案
“下班的时间放在哪哪里就有提升”
副业?;web3;licai
dataMars服务架构理解
todo 手画图
2.6-2.16:现有InfluxDB集群实例(只考虑data节点)的CPU、内存和存储资源已无法满足需求,需对资源配置进行扩展,以提升性能和稳定性。通过修改StatefulSet中cpu、memory配置并删除Pod触发StatefulSet控制器重建data节点Pod以应用新配置,通过修改data节点Pod对应的pvc中storage配置以触发pv的存储扩容(只能增加),实现资源变配(本地变配)
2.17:前端对齐开发,准备进入sit联调
2.18:插入需求“meta节点自定义创建”
2.28:整合已知信息已读代码->无法理解多节点类型实例如何发起变配,应该果断求助
3.3-3.10:改造influxdb集群为父子实例模式,改配置,传参调试,适配已有功能,考虑存量实例的影响
3.11-3.13:data变配基础上开发meta变配,云管订单遇到配额不匹配问题,上线延期下周
3.14:跨团队求助无果,请求协助,,新需求着手开发
3.17:搁置,开发新需求
3.18:实操tidb复现该“问题”,考虑转向与云管沟通。。
3.27:发版 =》InfluxDB父子实例改造/本地变配/节点/实例重启
读书时无所事事的日子,今天拔完牙和妈妈一起冰敷等待的日子,还有多少
刚开始普遍很难,易的是背八股,难的是落实和推进
如何跳出这个困境?如何跳出程序员行业?30岁,35岁
熬夜是因为没有对明天的渴望。但是在晚上的当下,有很多事情想做😿
喜欢一个人独处,是因为不想自己长期以来形成的情绪稳定被打破。害怕形成亲密关系,有时无法融入团体😿
2.18:本需求作为其他需求开发的前置条件
2.19:apisever打log上uat调试创建流程,从已部署分支git branch新分支以免影响正在使用者
2.21:提sql变更 1 dataspace提工单 2 直接进入各环境metadb(其本身为容器部署的mariadb服务) 3 某些配置项可通过datamars控制台修改
2.25:云管运营端商品信息变更,考虑是否影响存量实例;;1 云管释放旧实例将计价报错->调datamars管控接口释放/发版前释放旧实例 2 可以发起工单但无法下单->手动修改配额发起工单后过云管审批
2.27:发版流程、、代码合master,流水线打包使用(发版版本)部署,sql变更(定时,增加条件避免误订正),云运营变更(改一次console-cloud即各环境共用)
Steven👨🦲:裁员,残酷,危机感,,工作就是生活的很大一部分
deepseek:数据库方向是一个值得长期投入的领域,尤其适合对系统底层感兴趣的程序员。你的现有经验(运维+K8s)可成为切入云数据库或分布式数据库的跳板。建议以“运维需求驱动内核学习”为短期目标,逐步掌握分布式一致性、存储引擎等核心技术,同时通过开源贡献和项目实践构建技术影响力。=> https://yuanbao.tencent.com/bot/app/share/chat/c6b48985efa0c1101e5c6ae18c867724
rong teng:在midea得到的成长是显著的;(身兼开发运维多职,具体求职情况如何?)数据库方向有些窄;(作为senior求职需要专精时显得窄?作为基础能力学习可行?)应届生可以提转方向,转团队;以招聘市场心仪岗位的需求作为努力发展的方向!?
3.17:简单需求,父子workflow + k8s资源控制器
3.18:接口配置:接口信息查看mariadb已有的相同接口,其他信息参考influxdb自身的其他接口;前端联调完成
3.19:提测,发版:发版分支一周内进行 1 代码扫描-安全扫描 2 安全-软件成分-Web漏洞-灰盒,解决漏洞;代码仓库设置发版分支,史诗中关联所涉及仓库,检索其发版分支的扫描报告,手动关联web漏洞测试报告,质量门禁达标以通过安全卡点
1 | # 生成随机类名避免冲突 |
TEMP_JAVA="/tmp/${CLASS_NAME}.java")rm -f "$TEMP_JAVA")1 | System.out.println("USERNAME:" + username.trim()); |
1 | # 错误示例:初始方案采用`IFS`分割导致变量截断 |
1 | credentials=$(get_auth $1) # get_auth()动态生成java解密脚本并多行输出 |
1 | function select_data_pod() { |
| 方案 | 优点 | 缺点 |
|---|---|---|
| 文件存储 | 实现简单 | 存在安全风险 |
| 环境变量 | 进程内可见 | 长度受限 |
| 标准输出 | 无持久化风险 | 需严格格式控制 |
| 网络传输 | 适合分布式 | 增加复杂度 |
本项目完整代码已开源,读者可通过GitHub仓库获取最新版本。
3.28:需求分析->将pod迁移到集群的另一个资源充足的node上,并且恢复数据以及集群功能(元数据)
3.31-4.1:存量实例问题处理,, 建议客户使用改造后的influxdb实例,存量实例释放/启停/重启等功能遇到问题 =》未考虑好适配
4.2-4.7:出方案 1 sts指定亲合度规则以在指定node重建pod和pvc 2 开源influxdb-cluster功能不完全支持,考虑从分片副本层面恢复数据
4.8-4.10:数据恢复的主要思路=》从健康节点的分片副本copy-shard恢复出迁移节点原有的所有分片副本,?质疑->恢复过程中健康节点的分片副本持续写入的增量数据能否恢复??
4.11:考虑创建第3个Data-Pod替代迁移节点(从仍健康的迁移节点上迁移数据)× ->应该认为原节点完全不可用(相当于节点重搭了)设计方案参考其他数据库产品;;
4.14:推方案不动..自验证copy-shard达到预期效果,但无法解答原理,,自测方式还需模拟实际场景,多线程写入。。
4.15:写bash脚本批量写,开多终端模拟多线程,分片副本达70M+大流量2000point/s写 =》copy-shard恢复出分片副本与健康节点持续写的副本md5值不一致,恢复副本export文件小,猜测丢失数据
4.17:InfluxDB Data节点迁移方案评审:先迁移后逐个恢复分片数据。已验证在分片副本大小70M、写入数据达2000point/s的情况下直接copy-shard会导致增量数据丢失,考虑在copy-shard前先执行truncate-shards截断热分片(集群中所有写入最新数据的分片,截断后关闭写入,变成冷分片),并在所有Data节点上创建该分片的新热分片副本,也就是在迁移节点上恢复了全部原有分片的新热分片副本,最新数据写入这个副本,然后再逐个从健康节点上的冷分片副本copy-shard恢复出分片的历史数据(迁移前分片副本原有的数据&迁移过程中未能写入的数据),该分片数据完全恢复;自测符合预期
4.18-4.21:开发。发现原checkPodRebuildReady接口有时不符合预期,执行influxd-ctl指令(硬写成String在代码中)有时失效(meta no leader..),经常需要手工介入。。
4.22:提测
4.23:InfluxDB开源版可靠性不确定,,社区版,单节点,,开发,值班暂停
官方文档 https://influxdb-v1-docs-cn.cnosdb.com/influxdb/v1.8/introduction/install/
开源influxdb-cluster源码 https://github.com/chengshiwen/influxdb-cluster
Data节点迁移方案
故障矩阵: 架构 => 2 data 3 meta 副本因子为2
DBCLOUD开源DB报警群(实例),DBEngine告警群(机器),致命告警->数据库值班告警处理群,MariaDB/MySQL/MongoDB/PostgreSQL 常见问题,,
数据库开发&值班暂停
4.25-5.8:手动验证全流程+调通API,分阶段做,卡点及时同步到群聊.. 官网找接口文档/厂家提供,postPolicies接口参数调不好,就先手动设好用get查出来构造requestBody..
5.9-5.13:理清自动化接入和改造方案(先看一期代码,考虑接口和表能否复用),主动拉评审会议
5.14-5.16:开发及时理清需求原型和改造点,开发备份域配置管理界面
5.19-5.23:重难点=》作业平台下发备份客户端安装ansible脚本改造,根据传参when指定不同task,实现在target主机安装指定平台的client,expect实现交互式流程
5.26-5.29:NBU备份申请自动化开发,实现BackupNbuService(备份平台NBU涉及代码,构造RestTemplate调API);备份域配置“增删改查”,分页,模糊查询,@Transation处理先删后插/先改后改/先删后删。。延期->0605
6.3:自测=》页面上发起请求获得requestBody/通过postman调用本地起的后端服务,调试=》注释排查法/计算器debug
6.4:发sit,延期->0612;完善todo
6.5:自测,业务验收,ddl&dml(注意StringEncryptor加密的密钥随env变化!!) 发版,存在问题待完善
11.13:产品化客户验收(产品化环境开发、、接入客户环境、、)
制定2025年度重点工作计划。
快速开发InfluxDB服务化需求,持续优化已有功能;深度熟悉开源数据库,确保提供稳定服务。对齐其他数据库产品,了解用户实际需求,多方面考虑设计方案。做好值班任务。
希望提升的1-3项核心能力项,计划如何提升。
1 深入技术栈学习。阅读InfluxDB源码,学习数据库架构设计,K8s应用课程等,掌握高频业务场景的原理和运维技巧。
2 高效合作开发的能力。在全面思考,明确需求后开始开发,遇到卡点快速解决。
面向未来1年的职业规划。
本岗位沉淀
在这个阶段希望提高自己的工程能力,能比较全面地思考设计方案,快速开发和交付需求;还应该具备产品侧思考的能力,对一个系统有深入的认知,能够独当一面,做到专精一个领域。
工作成果
1.InfluxDB服务化体系构建
完成父子实例模式改造,新增InfluxDBMeta规格体系,实现节点级独立变配能力,为后续节点重启、迁移奠定基础;
针对Data节点迁移提出 “热分片截断-冷副本恢复”双阶段法,通过多线程大流量写入压力验证(2000 points/s),解决开源工具增量数据丢失问题;
参与数据库运维工作。
2.NBU备份自动化开发
支持备份平台自动化运维需求,开发基于Ansible的客户端安装脚本,整合NBU API,实现备份申请自动化;
开发备份域配置管理界面(增删改查+JSON字段模糊查询)
能力提升
在InfluxDB服务化需求开发中锻炼了“场景抽象-方案验证”的能力,从寻找开源社区方案到定制化能力开发(如备份集恢复、节点迁移及数据一致性保障),梳理故障矩阵(如单Data宕机、多Meta宕机的应对策略);在NBU备份自动化需求开发中能够快速上手Ansible脚本,复用已有能力,与用户及时沟通并完成开发。
存在不足
数据库开发方面需要积累技术深度,全面考虑方案并推动评审;自动化运维需求开发可以积累解决方案,缩短交付周期。
1 | ## 输入 |
6.27:页面流程理解+看“申请”自动化代码->考虑改造点,找api,输出文档
6.30-7.4:需求对齐,减少开发量的机会,,对于依赖项的变更(healthCheck->ResourcePool-VirtualServer)采用“蓝绿发布”=》先增后删
7.5-7.9:开发完成
7.10-7.11:自测,前端发起一次请求F12取payload / 后端接口处打印入参 + 按需修改 =》构造入参,走通流程,只需关注新加的代码(无关逻辑如校验/审批代码可以先注释掉。。)
7.14:变更成功后回滚。。手动修改+提sql同步配置;思考=》是不是可以直接另提一次变更,或者另外提供回滚接口,,总之此时回滚和前一次变更已经没有关联
7.17:上线。修复 1 管理员节点自动带出尽可能多参数 2 支持定时执行 3 思考:checkChangeSuccess()方法期望同步response,但方法里调API返回fail会隔10s重复十次,就是一直fail的话接口会隔100s才返回数据,假如加了一个定时任务扫描出待变更工单列表,用for循环执行change()并且各调用了checkChangeSuccess(),会发生什么,for循环卡住?”springboot项目,写了一个变更c…”点击查看元宝的回答
https://yuanbao.tencent.com/bot/app/share/chat/qqYiHTHYRWDv
7.29:支持定时执行,注意避免同一个工单被多次扫除(未完成变更后状态->EXECUTED),注意调度任务下发到本地节点,可能由于代码版本不同造成“灵异事件”
10.16:支持变更页面上的所有参数
10.30:支持回收自动化
11.13:优化提交工单时校验逻辑,避免重复补工单(按需增加存表字段&管理端加编辑后门)
解析值。。序列反序列parse,,JSONNode,,
1 | log.error("查询VirtualServer信息异常:"+e.getMessage(), e); |
todo
“一个Java系统开发完了,是怎么跑起来…” https://yb.tencent.com/s/jj0KGxxEGgzU
“IDEA调试、线上运行,Maven、SpringCloud…” https://yb.tencent.com/s/GB2sYz5WPHbB
集成,部署 “所谓的微服务实际上是怎么部署的呢…” https://yuanbao.tencent.com/bot/app/share/chat/gt96bRkSxuos
K8S&微服务部署方案 “k8s和springcloud是如何关联…” https://yuanbao.tencent.com/bot/app/share/chat/H2FtlSdK24y1
feature/v1.1.0发版完成后,拉出最多下两个版本的开发分支,如 bugfix/v1.1.0和 feature/v1.2.0,发版完成后合入线上分支和下一个版本分支。db文件上传git。nohup /usr/bin/java ${C_CMDB_XXL_JOB_EXECUTOR_ONEAGENT_OPTS} -Xms8g -Xmx8g -jar -Dspring.config.location=xx/application.yml -Djasypt.encryptor.password=xx xx.jar > xx.log 2>&1 &运维人员 -> 办公电脑 -> 访问入口 -> 堡垒机(安全审计核心) / 跳板机(简易通道) -> 内网 -> 物理机 / Linux后台(应用载体)
Linux基本命令:
netstat ; top; awk ; dstat; iostat; lsof; free, df;uptime;dmesg ;dig ; nslookup
vim/vi的基本快捷命令(gg, shift + g, :n ; dd, :%d ; yy, p ,u等)
终端的一些快捷命令(ctrl + a; ctrl + e)
1 | # 确认分区使用率 |
/etc/logrotate.d/zookeeper 中设置 daily, rotate 30, compress/apps 比 / 还大?1 | df -h |
1 | # 1. 查找Java应用PID |
1 | # 1:执行在线清空(命令通过文件名找到inode-A并清空数据块,Java进程仍拿着FD=10向原inode-A写日志) |
1 | # 2(错误):直接删除活跃日志文件,目录中文件消失,但Java的句柄FD10仍保留,仍持续写数据到inode-A |
cp + cat /dev/null >1 | cp 原文件 → 备份文件(inode-B) # 复制数据快照 |
cp 期间磁盘空间短暂翻倍(100GB 文件会占用 200GB),耗时较长(100GB ≈ 8 分钟),期间磁盘 IO 高;cp 完成到 cat /dev/null > 之间极短窗口内的日志会丢失(毫秒级,可接受)mv + touch + kill -HUP1 | mv 原文件 → 备份文件 # 瞬间重命名,inode-A 变成备份文件 |
mv 瞬间完成,不占额外磁盘空间,无翻倍风险, 适合超大日志文件场景kill -HUP 到 Logback 真正重新 open 之间有极短窗口,新日志仍写入备份文件(inode-A)1 | 业务代码 |
1 | ll /apps/logs/mongodb/archive/ |
Got signal: 6 (Aborted)(而非被外部 kill - Got signal: 15 (Terminated)):1 | grep "Got signal" /apps/logs/mongodb/archive/mongod30000.log.20XX-XX-XXT17-00-0X |
1 | # 替换为实际告警时间,格式:T小时:分 |
COLLSCAN(全表扫描)、耗时超过 1000ms 的查询、docsExamined 数量级是否异常大docsExamined 最大、耗时最长的那条,提取完整 filter:1 | grep "COLLSCAN" /tmp/crash_window.log | grep -oP '"find": "\K[^"]+' | sort | uniq -c | sort -rn |
1 | filter: { field1: "xxx", field2: "yyy" } ← 这是需要建索引的字段 |
1 | db.hello() |
hosts 列表里,通常是仲裁节点(Arbiter),不存数据,无需关注。1 | db.目标表名.createIndex( |
ip_1_source_1 生效,在 Compass Explain Plan 标签,填入原始 filter: { “ip”: “172.23.135.194”, “source”: “操作系统-其他IP-采集” },Explain 确认 COLLSCAN → IXSCAN,docsExamined: 213667 → 0,耗时 5097ms → 0ms服务:ops-data-access(对外接口)PRD | 端口:7119
关联:`ops-synapplication(实际入库)、MongoDB、Redis
1 | 最大繁忙线程数 |
1 | // MongoDB 审计表,找大批量写入请求 |
事故时间:2026-06-23 02:30 ~ 04:50
影响服务:data-center(CMDB 数据中心服务)
事故等级:P1(服务中断)
cat /dev/null > 清空大文件时暂时占用系统内存,把热数据挤到 Swap 里,导致内存数据混乱分布且无法自动恢复,最终引发 Swap 抖动和服务 OOM。cat /dev/null > data-center-1.0.log(50GB 文件)1 | `si`(Swap In)持续 1000~2000 KB/s:系统在拼命从 Swap 读取被访问的数据 |
1 | Java 访问对象 A(在 Swap)→ Swap In |
1 | ## **触发链** |
1 | # **日志证据** |
swapoff -a && swapon -a(强制清空 Swap,8GB 数据回到内存)cat /dev/null > data-center-1.0.log 清空 50GB 日志文件。truncate -s 0 data-center-1.0.log1 | **触发机制**: |
1 | 物理内存 13.65GB(91% 使用率): |
cat /dev/null > 执行瞬间,内核处理 50GB 文件截断,Page Cache 临时占用 8GB。物理内存不足(13.65GB + 8GB = 21.65GB > 15GB),内核 LRU 算法在需要腾出 8GB 时,把刚用过几分钟的 Java/ilogtail 数据也当”冷数据”换出——**这是”误判”**:正常只需换出 1.1GB 冷数据,这次却换出了包含 4GB 活跃对象的 7GB 数据,Swap 从 1.1GB 暴涨到 8GB。1 | 异常状态(02:32 之后): |
| 状态 | 内存使用 | Swap 使用 | Swap 内容 | 系统稳定性 |
|---|---|---|---|---|
| 正常 | 13.65GB(活跃数据) | 1.1GB(14%) | 全是冷数据 | ✅ 稳定,Swap 几乎不被访问 |
| 异常 | 波动 | 8GB(100%) | 4GB 热数据 + 4GB 冷数据 | ❌ Swap 抖动,永久震荡 |
1 | cat /dev/null > 50GB 文件 → Page Cache 临时占用 8GB |
1 | uptime |
1 | free -h |
1 | vmstat 1 5 |
1 | top |
1 | # 统计有多少进程在用 Swap |
swapoff 需要将 Swap 里的 8GB 数据全部读回内存,但可用内存只有 1.8GB,物理上不够。1 | sudo systemctl stop logagent |
1 | sudo swapoff -a && sudo swapon -a |
1 | sudo systemctl start logagent |
1 | Load: 0.40 |
| 状态 | Swap 使用率 | Load | vmstat si/so | 是否正常 |
|---|---|---|---|---|
| 健康依赖 | 5~15% | < 2 | si=0, so=0 | ✅ 正常(冷数据在 Swap) |
| 危险边缘 | 80~99% | 3~6 | si>100 KB/s | ⚠️ 警戒(热数据开始被换出) |
| Swap 抖动 | 100% | >10 | si>1000, so>1000 | 🔴 故障(热数据混杂,无法恢复) |
0 2 * * * sh /apps/devops/data-center/data-center-log-backup.shcheckPort 方法使用了 7+ 个模块共享的线程池 queryCmdbValidIpExecutor(核心线程数 15)。高峰期其他模块的长耗时任务占满了全部 15 个核心线程,checkPort 的任务只能排队等待,而上层 validatePorts 调用的是 Future.join()(无超时阻塞),导致 API 处理线程永久 pending,直到客户端超时。1 | API 请求 |
1 | @Bean |
mops-platform-backend 服务的 Tomcat 线程池指标(活跃线程数、连接数、请求数等),导致线上问题缺乏可观测性。application.yml 主配置中添加一行:1 | server: |
1 | 生效链路 → |
mbeanregistry.enabled=true 覆盖默认值(显式覆盖默认行为)@EnableAutoConfiguration 扫描 classpath,检测到 tomcat-embed-core 存在,自动创建嵌入式 Tomcat Bean,无需任何 XML 配置。这是”约定”的底层实现机制。queryUserResource 接口偶发 500,错误信息 “ES查询失败”httpcomponents JAR 包版本冲突。elasticsearch-rest-high-level-client 7.17.23 需要 httpcore-nio 4.4.14+,但 Spring Boot 1.5.10 将其降级到 4.4.6。ES 服务端今天 10:22 主动断开连接时,客户端处理断连逻辑触发了缺失的构造方法,导致 I/O reactor 线程崩溃且无法自愈,此后所有 ES 请求全部失败。RestHighLevelClient 有连接池和自动重连机制,ES 服务端断连后客户端会自动重建连接,不需要重启。但本次由于版本冲突,reactor 在处理断连的过程中自己崩溃了——不是断连本身导致连不上,而是处理断连时抛出 NoSuchMethodError 导致整个客户端实例废掉。RUNNING → STOPPED),没有自愈路径,只能通过重启服务重新创建 RestHighLevelClient 实例来恢复。修复版本冲突后,断连会走正常处理流程,不再触发崩溃。INFO.0.log 里搜查询 es接口的错误日志 Error executing search request 没有结果,卡在这里。ERROR 级别所有日志,反而一次性暴露了两个现象——大量 I/O reactor status: STOPPED 和少量 callPaasError,并且从时间戳上看出 STOPPED 在前、callPaasError 在后,有明确的因果关系。grep -n 定位 STOPPED 第一次出现的行号,再用 sed -n 取该行前后的日志,找到崩溃的直接异常 NoSuchMethodError,再往前一屏找到触发原因 ConnectionClosedException: Connection closed unexpectedly。NoSuchMethodError 是版本冲突的典型特征。结合 pom.xml 中 elasticsearch 7.17.23 + Spring Boot 1.5.10 的组合,直接锁定冲突的 JAR 包和版本差异。1 | 10:22:00 ES 服务端主动断开连接 |
LIKE '%值%',无法利用 B-Tree 索引IN 列表(可达数千条),在与 LIKE 并存时优化器会放弃索引改走全表扫1 | POST /backup/getExecRecord |
1 | KEY idx_system_name (system_name) -- 仅无 LIKE 时有效 |
| 场景矩阵 | isHomePage? | 有 LIKE? | 有 IN? | 是否慢? | 原因 | EXPLAIN |
|---|---|---|---|---|---|---|
| 用户端默认进入,无过滤 | true | 否 | 是(权限列表) | 否 | idx_system_name 生效 |
type=ref key=idx_system_name rows=少量 |
| 用户端 + LIKE + 权限 IN | true | 是 | 是(大量) | 是 | LIKE 导致 IN 索引被放弃 | id=1 t ALL possible_keys=idx_system_name key=NULL rows=1,868,591 Using where id=1 id=2 MATERIALIZED id=3 DERIVED No tables used |
| 管理端,仅 LIKE,无 IN | false | 是 | 否 | 最慢 | 无任何索引入口,全表扫 | type=ALL key=NULL rows=3,405,177 Extra=Using where |
| 管理端,LIKE + 少量 IN | false | 是 | 是(少量) | 有风险 | IN 列表很短时 idx_system_name 可能生效,但加了 %LIKE% 后优化器不稳定,数据量大时仍有慢查询风险 | ~ |
%LIKE%会使优化器放弃 B-Tree 索引。1 | -- **关键 EXPLAIN 对比:** |
1 | // 改前 |
1 | ALTER TABLE backup_exec_record ADD INDEX idx_backup_type (backup_type); |
idx_backup_type 将候选集缩小到该类型的子集,后续 LIKE 在小集合上过滤,覆盖绝大多数查询场景。1 | .and(StrUtil.isNotEmpty(condition.getIpAddress()), w -> { |
1 | ALTER TABLE backup_exec_record ADD INDEX idx_ip_address (ip_address); |
10.25.)走索引范围扫描,避免全表扫。% 即可利用索引。 1 | // 改前 |
1 | T+0 定时任务每 5 分钟触发一次采集任务下发 |
1 | jstat → Old 区 99.97%,Full GC 无法释放内存 |
1 | // 锁住整个 Service 实例,所有线程全局串行 |
analysisAutoData() 对每条采集记录循环调用一次,在锁持有期间产生大量短生命周期大对象。 1 | 证据链: |
1 | Full GC STW(每次 600ms)恶性死循环 |
1 | 故障时:-Xms512m -Xmx1g |
1 | // 每条 Kafka 消息创建一个新线程,无上限 |
operKafkaData() 就退出,对象可以被 GC 回收。Kafka Coordinator Dead 后反复重连(而非彻底退出消费组),导致新消息持续涌入,新线程持续创建,内存压力持续增大。1 | // 现状:全局锁,锁内执行数十秒重 IO |
1 | // 现状:无上限裸线程 |
CallerRunsPolicy 的作用:线程池满时由 Kafka 消费线程自己执行任务,消费速度自动降低,形成背压,避免无限堆积。1 | # 现状:自动提交,重启会丢失已消费未入库的消息 |
1 | -Xms4g -Xmx4g # 堆大小,建议取可用内存 40~50% |
1 | 1. 登录宿主机,发现 7001 端口由 Docker 容器监听 |
1 | management: |
1 | sudo docker restart 5f6b2e982c53 |
netstat 看到 docker-proxy 说明是容器端口映射,docker ps | grep 端口 找到对应容器include: "*" 会暴露 heapdump(含密码/token)、env(含明文配置)等高危端点,生产环境应只保留 health/infodocker inspect 看 Mounts,bind mount 类型直接改宿主机文件重启生效,无需重建镜像现象: CMDB 集群整体停止后重新启动,ZooKeeper 3个 Pod 持续处于 CrashLoopBackOff 状态,集群无法自动恢复。
前因后果:
/data/conf/zoo.cfg.dynamic.<版本号>,里面记录的是各节点的 Pod IP/data/zoo.cfg.dynamic(含新 IP),但 zoo.cfg 里的指针指向的是版本化文件,新文件根本不会被读到( zoo.cfg 里有:dynamicConfigFile=/data/conf/zoo.cfg.dynamic.400000016,这个指针是 ZooKeeper 自己通过 reconfig 机制写入并维护的,每次配置变更都会更新版本号,PVC 里存的永远是最新版本化文件的路径,启动时就直接读它。)bind(旧IP:3888) → 该 IP 已不存在 → BindException → 进程退出 → CrashLoopBackOffzoo.cfg.dynamic 文件(内含旧 IP),将 zoo.cfg 指针改为 /data/zoo.cfg.dynamic(启动脚本生成的新文件),等 Pod-0 自动重试启动 → 单节点选主 → 推送配置给 Pod-1/2 → 集群恢复zkCli.sh reconfig,将三节点成员地址从 Pod IP 改为 Headless Service DNS 域名,reconfig 会把域名写入新版本化文件并同步到三个节点的 PVC,验证 delete 三个 Pod,IP 全部变化,集群自动恢复,RESTARTS=0,改进完成zookeeperStart.sh 在镜像里,生成配置时写的是 Pod IP,长期方案是修改镜像,让脚本直接写域名8.1:梳理变更场景,4种记录+2种平台,拆解为每种记录只有增删改三种操作,一步步实现即可
8.2-8.10:大假,昆明-大理-贵阳-深圳
8.11-8.15:收集+验证现状,还需拉会议评审
8.17:后续每天定 每日计划…
0818:DNS变更,确定所有api/script(√),方案评审(×)
0819:DNS变更主流程(80%)
0820:DNS变更主流程(90%)
0821:管理端加失败工单入库按钮,当日上线
0822-0824:DNS变更开发
0825:DNS变更自测(√),CMDB安全组件安装流程确定(×)
0826:DNS变更sit(√),CMDB安全组件安装(×)
0827:DNS变更全流程报错机制完善,1.流程节点失败就报错 2.ticket.setExecutionLog(+=新日志) 那么可以全程操作溯源、、成功就直接加,失败throwE在catch里加e.getMessage()
0828:涉及定时任务调度/异步的要考虑UserContext空指针;上线
0908:一键回退主流程开发
0916:一键回退上线
1016:全面支持mx+txt申请变更回收,通过workspace让AI“模仿”cname自动化来实现
1030:支持智能解析,todo->cmdb字段回写+移动审批带出
11.18:产品化需求->Windows DNS自动化下发,适配进常规DNS下发流程(midea生产和产品化环境通过前端开放不同入口,实现执行不同部分代码,下发不同platform的DNS配置)
1202:变更一键回退优化(直接挂回原pool),支持申请回退(即回收掉)
后续 → 交接给外包
4.9:不是一股脑交给外包,而是把握、控制好需求、功能后交给外包实现
6.30:变更/回收前同步“元数据”,用于变更/回收脚本下发和一键回退,认为平台值不可信;至此DNS场景基本覆盖完善
二阶段提交以保证两份日志保持逻辑一致)-> 两份日志都成功写入磁盘后,被修改的数据页(脏页)并不会立即写入磁盘,而是由 MySQL 在“后台”选择一个合适的时机异步刷盘。 刚刚好找出这张照片,刚好这一天的头发服帖,刚好朋友拍出了不错的构图,脸上也满是生气,好像有勇气冲到一个新的level
但最近我都在跑医院,想着每个周末只是在修复自己的身体和精神,到了工作日又要回去摧残自己..这有什么意义吗
为了回归到这张照片,想了半天得出一个结论是,不断地修复自己到一个刚刚好的状态就是生活的意义,吗
有点虚无,说了但像什么也没说,什么又是一个刚刚好的状态呢
也许是我刚好能够面对相机,刚好拍下了这张照片
也许人置身生活的洪流,只能不断修复自己
也许可以找到互相修复的人
接手CMDB,,从做需求->做系统 https://yuanbao.tencent.com/bot/app/share/chat/920NVAbsqwtm
最大化CMDB项目的学习价值,, https://yuanbao.tencent.com/bot/app/share/chat/SzQrsGlsuz88
| 简历模块 | 平庸写法 | 高价值写法(量化+技术关键词) |
|---|---|---|
| 项目经验 | 参与CMDB需求开发 | 主导CMDB数据模型重构,设计弹性CI架构,支持200+动态属性扩展,模型变更效率提升40% |
| 技术亮点 | 使用Spring Cloud开发API | 基于Quartz+Netty开发高并发自动发现引擎,单节点支持5000+设备/秒采集 |
| 业务价值 | 提升系统稳定性 | 通过拓扑影响分析模块,故障定位时效从30min缩短至5min,年止损运维成本200万+ |
💡 简历筛选口诀:“技术深度×业务影响”双突出——避免写“增删改查”,聚焦架构设计、性能优化、跨系统集成。
1 | 用户浏览器 |
1 | 外部请求 |
why mongo?文档型数据库,灵活加减字段(新的记录生效,旧的不影响?)
一主一从一hidden
查数据慢,大概率是mongodb的负载过高,或慢查询(索引没有或者失效)。
负载居高不下,该怎么处理?kill超过**秒的慢查询。 重启CMDB应用,杀掉堆积的大量慢查询请求。。
MongoDB慢sql: CMDB MongoDB 从节点 10.18.52.147 异常崩溃,当时已重启恢复,副本集状态正常;根因是高并发 COLLSCAN 查询叠加导致资源异常,最大问题查询 ip_manager_instance_data 全表扫描 21.3 万文档,耗时 5 秒,读取 12.9MB
测试环境已针对慢查询表和查询条件添加索引,验证已生效,下班后在生产也添加,后续出现类似告警我都跟进下
核心功能,,读写,控制并发,流量多少??
校验 责任链,幂等,,
查询/视图接口慢,,服务负载高,内存高,tomcat,线程池满了,,数据库慢加
[图片]
1 | MongoDB(业务数据) |
{cit}_instance_data。在 monscache 库维护两个集合:monstache 集合):记录当前同步到的 oplog 位置,重启后续传directreads 集合):记录哪些表已完成全量同步,避免重复扫描1 | mongo-url = "mongodb://..." # MongoDB 连接 |
cmdb_{cit别名},对应 CMDB 的一个配置表,新增 CIT 类型需先手动建索引再由 Monstache 同步。query_string 全字段匹配,等价 DSL:1 | { |
1 | Monstache 启动 |
db.directreads.deleteMany({}),重启 Monstache 即可1 | MongoDB 集群(副本集) |
topicname-partition-offset,写入 Redis,TTL 2分钟; 同一条消息重复投递时直接跳过,防止重启后重复回调(??重复消费kafka)_id,回查 MongoDB 获取最新完整数据(ChangeStream 只携带变更字段) - DELETE:从消息体取文档主键message_subscriber 集合中,- 匹配维度:collection 名、操作类型(INSERT/UPDATE/DELETE)、字段级过滤 - 配置带 Redis 缓存(TTL 60分钟),减少 MongoDB 查询压力IOException: 设备上没有空间/apps 分区 100% 满,api_call_audit topic 数据占用约 30Gapi_call_audit topic 写入量突增,叠加 retention 只配置了时间(7天)未限制大小,磁盘被写满,三台 broker 先后崩溃,整个 Kafka 集群不可用。防火墙采集 &fullgc
入库 kafka消费,new Thread,,并发控制
0712 fullgc 看优化 1、锁粒度控制 2、有界线程池 3、citfieldsinfo 用redis缓存

ChatClient ←→ PromptTemplate ←→ ChatResponse1 | // 1. LLM解析 → 需要调用queryHosts工具,参数: osType="Linux", minMemory=8 |
1 | // 1. LLM解析 → 需要调用queryHosts工具,参数: osType="Linux", minMemory=8 |
1 | // 1. RAG检索 → 相关性能优化文档 |
可体验的竞品:
竞品核心功能提取:
• 自然语言转查询:”内存大于8G的服务器” → MongoDB查询
• 结果格式化:表格、图表、自然语言总结
• 错误处理:查询无结果时的智能建议
(Python demo using LangGraph) https://github.com/leo710aka/CMDB-Chat/blob/main/cmdb_chat.py
nl2sql开源项目:https://java2ai.com/agents/dataagent/quick-start/
1.16-1.22:MOPS大洋产品化功能验证。。差异本地起多服务验证,在sit环境验证poc分支代码,要注意配置差异
1.23:容器化服务验证 → image上传-bundle打包load到私有仓-pod重启,分步验证,相信自己能解决问题。
1.26:不管在什么环境,排查问题看日志(项目配置里查,不懂就问,超过1h解决不了就抛出)
2.10:大洋uat演示
2.26:私有化代码迭代规范搞清楚(主干分支,迭代分支,输出分支)
3.20:关键是理解用什么分支,出什么包(什么仓库什么标签的image),部署到什么环境
5.11:NBU整机备份验收
5.15:?windowsDNS改造WinRM下发(解决ssh登录执行ps指令二跳认证问题)
pom.xml 文件。它定义了项目坐标、依赖的第三方库(如Spring Boot)、插件等。一个基本的打包命令是 mvn clean package,执行后会在 target/ 目录生成可运行的JAR包。java -jar 直接运行,是Spring Boot的默认方式。Thin JAR 则只包含您自己的代码,运行时需要显式指定依赖库的路径(Classpath)。java -jar your-application.jar 即可启动应用。您可以通过 --server.port=8081 这样的参数覆盖配置文件中的设置。ps -ef | grep java 或 jps -l 命令,可以查看当前系统中所有Java进程的PID(进程ID)和主类名。kill -9 <PID> 可以强制终止一个Java进程。更优雅的方式是在应用中通过Actuator端点实现kill -15 <PID>(发送SIGTERM信号),允许程序完成当前任务后再退出。nohup java -jar your-app.jar > /path/to/app.log 2>&1 & 命令实现后台运行并将日志输出到文件。ThreadPoolExecutor)来管理和复用线程,减少资源消耗。在Spring Boot中,利用 @Async 注解可以轻松实现异步方法调用。使用 top -H -p <PID> 命令可以查看某个Java进程内各个线程的CPU和内存占用情况,帮助识别资源消耗大户。curl -O https://arthas.aliyun.com/arthas-boot.jar 下载,然后用 java -jar arthas-boot.jar 启动并选择要诊断的Java进程。dashboard:实时仪表盘,总览系统状态。thread:查看所有线程堆栈,找出阻塞或CPU占用高的线程。watch com.example.YourClass yourMethod "{params, returnObj}" -x 3:动态观察方法调用的入参和返回trace com.example.YourClass yourMethod:追踪方法内部调用路径及每个环节的耗时。java -version 和 mvn -v 验证。Spring Web 依赖)。在项目根目录执行 mvn clean package,观察 target/ 目录下生成的 .jar 文件。java -jar target/your-demo-app.jar。jps -l 找到该进程的PID,用 ps -ef | grep java 查看详细信息。http://localhost:8080 验证应用。kill -15 <PID> 优雅停止应用。thread 命令找到繁忙线程,再用 stack 命令查看该线程的完整堆栈,定位问题代码。^^
// todo:本地?远程linux?实验
确定自己的项目边界,,杂事给外包??运营工作形成sop
确定主线、支线任务,,每天能回想起自己做了什么吗。。
找到专精??晋升,数据库,,
ai coding
1.5:CMDB问数项目启动
1.7:datamax问数体验,开启多轮问答方案调研(确定表-确定字段-确定sql..)
1.9:DataAgent项目体验,SpringAiAlibaba,Apache2.0
1.11:DataAgent配置llm+embedding,初始化数据源embedding到本地vectorStore,,Graph多轮问数
1.12:DataAgent验证业务提供的场景
1.15:多轮验证报告=》可能提高准确性,但需要维护多个节点
2.26-3.6:基于DataAgent二开 → 看详细功能实现,多轮逻辑图,节点路由关系,每个节点做了什么,,
3.7-:定制化改造,结合内部场景验证,完善缺陷。。
laster:CMDB交接,,问数项目sit验证,“后面能不能发都不知道了”
1 | # 编写 Dockerfile(极简模板,可直接复用): |
1 | # 用命令创建命名空间(示例:命名空间名为 demo) |
1 | apiVersion: apps/v1 |
1 | apiVersion: v1 |
1 | apiVersion: networking.k8s.io/v1 |
【结论】Java 服务在 K8s 跑起来后,外部访问入口本质是:Ingress 关联的 IP + Java API 路径(通常不需要额外加 Port)
配置的 Ingress 规则,本质是告诉 Ingress Controller:“当收到某个 IP / 域名 + 路径的请求时,转发到对应的 Service → Pod → Java 服务”
无需关心 Service IP 和 Pod IP,Ingress 已经帮你做好了所有转发。
| 组件 | 核心职责 | 是否会变 |
|---|---|---|
| Deployment | 管理 Pod 生命周期(升级、自愈、副本数) | 配置不变则不变 |
| Pod | 运行 Java 容器,集群内部私网 IP | 更新镜像/重建时,IP 必变 |
| Service | 固定内部入口,负载均衡到 Pod | 不删除则 IP 不变 |
| Ingress 规则 | 配置外部域名→Service 的路由 | 不修改则不变 |
| Ingress Controller | 执行转发,集群全局组件 | 运维维护,通常不变 |
外部用户访问 → 域名 DNS 解析 → Ingress Controller(ingress-nginx 命名空间)
→ 匹配 Ingress 规则(demo 命名空间) → 转发到 Service(demo 命名空间,固定 IP)
→ Service 负载均衡(DNAT) → 转发到某个 Pod(demo 命名空间,私网 IP)
→ Pod 内 Java 容器处理请求 → 返回数据
微服务架构中,有到网关微服务,负责选具体服务的节点
1 | 🌍 用户浏览器 |
一句话极简链路:浏览器 → DNS → 节点IP:80 → Ingress Controller → 网关Service → 网关Pod → 业务Service → 业务Pod
K8s环境服务访问,相互调用
轻量化??
todo:https://time.geekbang.org/column/intro/100015201?tab=catalog
| 阈值 | 判断 |
|---|---|
| < 100ms | 正常 |
| 100ms ~ 1s | 关注,高频接口需优化 |
| > 1s | 慢 SQL,需处理 |
| > 3s | 严重,必须处理 |
select_type——子查询的执行策略| 值 | 含义 | 好坏 |
|---|---|---|
| PRIMARY | 主查询 | — |
| MATERIALIZED | 子查询物化,只执行一次 | ✅ 好 |
| DEPENDENT SUBQUERY | 相关子查询,主表每行执行一次 | ❌ 危险 |
| SUBQUERY | 独立子查询,执行一次 | ✅ 好 |
DEPENDENT SUBQUERY 是慢 SQL 的高危信号,主表 N 行 × 子查询 M 行 = N×M 代价
type——单表访问方式(性能从好到坏)| 值 | 含义 | 好坏 |
|---|---|---|
| ref | 索引等值查找 | ✅ |
| range | 索引范围扫描 | ✅ |
| index | 全索引扫描 | ⚠️ |
| ALL | 全表扫描 | ❌ |
const > eq_ref > ref > range > index > ALL
key——实际用的索引(NULL = 没用索引,结合 type=ALL 是最差情况;有值但 type 仍是 index/ALL,说明索引未能有效过滤)rows——预估扫描行数(越大越慢;DEPENDENT SUBQUERY 的 rows 要 × 主表 rows,是乘法关系)Extra——额外信息| 值 | 含义 |
|---|---|
| Using where | 引擎拿到数据后 Server 层再过滤,正常 |
| Using index | 覆盖索引,无需回表,✅ 好 |
| Using index condition | 索引条件下推(ICP),减少回表,✅ 好 |
| Using filesort | 需要额外排序,⚠️ 关注 |
| Using temporary | 用了临时表,⚠️ 关注 |
1 | 按以下顺序逐一排查: |
优先级从高到低:
| 策略 | 适用场景 | 收益 |
|---|---|---|
| 消除 DEPENDENT SUBQUERY | 子查询被反复执行 | 从 O(N×M) → O(N+M),数量级提升 |
| 加索引 | type=ALL 且 WHERE 列无索引 | 从全表扫 → 索引查找,数量级提升 |
| 去掉子查询中多余的 JOIN | JOIN 列与 SELECT 列相同导致 DEPENDENT | 可能让优化器改为 MATERIALIZED |
| 覆盖索引 | 频繁回表 | 消除回表,中等收益 |
| 改写为 LEFT JOIN IS NULL | NOT IN 子查询 | 视情况,需验证 |
⚠️ LEFT JOIN 改写不一定更快:如果主表没有先缩小范围就做全量 JOIN,反而会更慢(本次实验验证过)
改完后重新 EXPLAIN,对比关键列变化
重点确认:
1 DEPENDENT SUBQUERY 是否消失或 rows 大幅减少
2 type=ALL 是否变为 ref(索引等值查找)/ range(索引范围扫描)
3 key=NULL 是否命中了索引
再实际执行计时,和改前对比
// todo: 多次实践
email、file、baidu-drive、webdav… 核心:定义统一的输入输出格式 ,模型只跟 Skill 说话,不碰具体系统qq-email-adapter - 163-email-adapter - baidu-drive-adapteremail , 生成统一参数:1 | { "skill": "email", "action": "list", "params": { "limit": 3 } } |
email.list(limit=3), 看你配置:你的邮箱是 xxx@qq.com → 自动路由到 QQ 邮箱适配器, 把参数补全:1 | { "host": "imap.qq.com", "port": 993, "user": "xxx@qq.com", "pass": "授权码", "limit": 3 } |
1 | [ |
1 | 用户自然语言指令 |
FileRead/FileEdit/Write(多文件批量改)BashTool(编译、测试、打包、Docker)GitStatus/Commit/Push/PRRipgrep(代码库全局搜索)rm/docker),安全可控。[近年AI应用技术串讲与优质文档分享|Agent、Skill、OpenClaw、Harness……]https://oigi8odzc5w.feishu.cn/wiki/WBMfwiNkfi6uNFkRtXdcavDzn0e
todo 设计、开发一个 【监控】 高并发系统,学习多线程、mysql锁、、
1 | // C:\Users\caife\.claude.json → 配置免登录 |
1 | # 1. 正确的API中转地址 |
1 | # 进入交互式对话,然后直接打字提问 |
CC Switch 可以统一为本地的各CLI配置各模型厂商,启用后 /model 可以看到当前在用模型,无需配置环境变量(下载 xx.windows.msi → https://github.com/farion1231/cc-switch/releases)Vibe Coding 新手起步:必做清单Token 是 AI 处理文本的最小单位。Context Engineer)1 | 长期记忆(磁盘) --> 会话开始时加载 --> 进入上下文窗口(短期记忆) |
1 | # Memory Index |
1 | ● Skill 已创建完成。结构如下: |
1 | > /update-config |
1 | ● User answered Claude's questions: |
MOPS & CMDB & Ansible(运维平台,数据底座 + 运维作业)
MOPS:通过工单触发一个申请/变更/回收流程,通过生成的记录映射到的实际平台上的策略,用API/script做自动化,运维数据落到 CMDB。。流程 可靠(可追溯、可回滚),运维数据全流程闭环,,
作业平台:免密ssh下发(执行机root存私钥,目标机mdauto存公钥),高并发,高可用??三个节点,100个任务,怎么调度,怎么等待??
CMDB:运维事实库,本质就是如何把数据写入,如何供外部使用,日常/私有化迭代(只做热点运维工作,日常用户答疑,没有深耕功能和组件)
CMDB Copilot:基于CMDB数据源的nl2sql问数服务。。搞容器化 → 不用框架,只用通用模型+上下文工程+skills(提示词工程) 怎么实现??
嘉为蓝鲸,Azure 智能运维
价值,用户,钱
ToB:流程和稳定(业务复杂,数据准确,并发要求低),超出客户期待
中立云:目标客户→对成本重视的企业の数量级>>对成本不重视的,对公有云降维打击,占领云计算的农村
迭代:私有化主干分支 feature/product_output 或 poc(区别于内部main分支,两个分别维护,短期方便但长期废人力),私有化迭代分支 feature/priv1.x.0(初期从主干拉出,迭代开发私有化功能),私有化Release版本(中期从主干拉出,私有feature测完后合入,出正式的私有化镜像包)
单一master分支改造:大洋代码合回内部主分支,后续迭代考虑如何一套代码跑多个环境。。客户适应系统,而不是系统适配客户??
MOPS:懂关键能力实现&组件原理,,慢sql治理??线上问题,服务、DB、中间件不可用??
运维作业:流量大怎么做(分批,下班时间),失败怎么做(重试?保证数据一致性;考虑如果失败的堆积到一起重试流量太大。。)
稳定性建设:四大类检查
故障复盘
运维产品
数据库运维
AI Coding:形成开发规范 1)理解项目(形成doc,skill??团队经验)2)配置代码格式等 3)AI根据需求描述生成计划,头脑风暴 4)分步开发(太长思考中断)
AI工程vs传统工程 —「道法术」中的变与不变 https://mp.weixin.qq.com/s/Foiid7aYvTD0-ejBSGhM7A
AI 驱动的智能异常处置:从异常发现到根因定位 https://mp.weixin.qq.com/s/VHqYQ-cnburG8ydI94F_DA
凌晨 3 点故障告警,我让 AI 在 10 分钟内找到了根因 https://mp.weixin.qq.com/s/Ru_tYyofOqnKitzAU7Bu7g
事情多,都紧急,人脑过载,效率低,,
我总是在等一个时机
等有时间再看项目疑难问题
等有时间再学容器化、K8S、调优
stn:没有舒适区
老板好,临近年中,我梳理了下近半年的工作重点:期间完成了 MOPS 所负责业务的持续优化,Opspace 私有化部署,CMDB 问数项目初步上线,同时也更多承担了团队协作事项,日常也有在扩充自身技术栈。
不过对照年初沟通时,您对我的发展期许来看,目前我实际负责的工作内容还是有一定出入。所以想借年中这个节点,跟您再对齐一下您对我的个人成长期望,以及我后续的工作重心安排。另外年初我主动提过想要争取晋升,也想听听您对我现阶段工作的整体评价,以及我自身还需要做出哪些调整改进。
老板下午好,今天是想跟您同步一下我近半年的工作产出、个人成长,以及现阶段的一些想法与困惑。
第一,我持续在做运维平台所负责模块的迭代优化,掌握需求对接和交付的全流程,特别是对DNS自动化这一块做了全场景的梳理和优化方案,也把业务经验沉淀了skill。另外主动支持两位外包做负载均衡和DNS相关需求的方案评审。
第二,大洋私有化交付方面。我不仅完成了自己功能的跑通,更是对整体部署交付流程有了更深的理解,能够积极响应用户问题和需求,支持定制开发和优化,目前是这方面的主力。CMDB 产品化日常迭代也是我在负责。
第三,CMDB智能问数项目,从业务知识梳理、问数场景搜集,到多轮问数定制开发和最终的服务上线均全程改进。当然我清楚知晓,在知识库和问题调试上还有要优化的空间,我也很愿意接下来继续投入时间在这上面。
第四,更多的承担了团队日常值班、发版、线上问题处理,sql优化,CMDB日常运营。
这半年我最大的转变,就是从被动接受任务,到主动梳理工作重点,推进项目,及时同步进展。占用团队资源更少了,能够负责的事务更多了,几位前辈也应该能比较明显感受到。
当然我也有一些困惑,您之前一直给我提的独当一面,事实上我更多的是负责了更多更广泛的业务,而不是专精一个方面。而且近几个月都是高强度满负荷的工作,感觉自己被困在了各种迭代优化的细致项上了,私有化交付更是需要频繁和用户沟通,一直被分散精力,缺少深挖技术的场景(?)。这方面希望您给我一些方向上的指点。
年初的时候我主动跟您提过想争取晋升的机会。我自认为近两年已经有了比较大的成长,也能够实际的承担更多工作。解决实际问题,独立开发。我入职时的薪资就是低于行业平均标准的,但是一直积极进取,也真心希望得到公司的认可,希望能把握住晋升机会。这一块想了解您对我的评价?在哪些方面要重点改进?
开发能力肯定ok
架构(服务拆分,中间件选择,高可用,数据库,微服务,服务治理)
代码规范(《重构》,学习优秀开源项目,Spring)
AI使用(主动学,窗口期1-2y,思考用ClaudeCode怎么做CMDB问数)
做AI运维(主动拓展scope,从日常的杂活中抽理出来,看别人的=自己做了)
独当一面(一方面是能够解决热点问题,一方面是能从0到1落地项目)
保持好奇心
嫡系应届生专属深度谈心方案
hr talk
新boss 一对一完整沟通方案
沟通核心目标(最重要)
1)可量化、可落地的工作:2 次、5 个、8 项、10 +,数据支撑足
2)有具体思路和操作,不是“我做了什么”,而是“我解决了什么”
kafka-2.xx/config/.. 文件前置环境变量:
BK=xxx:9092(集群地址,替换成实际集群)、TOPIC=xxx、GROUP=xxx
1 | # 1.查看全量消费组,找到异常Topic绑定的消费组( 原生没有命令可以「根据 Topic 反向查所有消费组」) |
1 | # 2.查看Topic分区信息,确认分区数量、副本状态 |
1 | # 查看消费组全分区堆积LAG、消费位点、绑定消费实例 |
1 | # 1. 实时监听新消息(看当前涌入的异常消息,从头消费不建议,堆积量大会卡) |
1 | # 2. 只读取20条最新消息,快速抽样 |
kafka-topics.sh --bootstrap-server $BK --describe --topic $TOPICkubectl get pods -n 业务ns | grep 服务名,查看是否CrashLoopBackOff;kafka-consumer-groups.sh --bootstrap-server $BK --group $GROUP --topic $TOPIC --reset-offsets --to-latest --execute1 | #1.扩容Topic分区(提升最大并发,分区只能加不能减) |
一、自动化运维平台能力建设
主导 F5 负载均衡、DNS 域名解析、NBU 备份自动化搭建。完善负载均衡变更、回收自动化链路,减少手工运维成本与操作风险;覆盖 DNS 各类域名申请、变更、回收自动化场景,近半年工单数1000+,创新打造一键回退功能,支持临时域名快速回收、变更故障回滚场景,收获业务方认可。
日常承担平台发版、值班、系统调优等团队事务,负责 F5、DNS 模块需求方案评审,协同团队落地负载均衡变更一键回退、DNS 自动采集、续期盘点等功能。后续将承接防火墙模块,负责网络管理模块迭代。
二、OPSpace 产品化交付
全程跟进 OPSpace 在大洋电机从测试到生产环境交付。核心完成 Windows DNS、NBU 备份自动化的客户侧适配搭建,实现顶级域名可配置、NBU 整机备份等定制化能力,协同客户完成上线验收并输出操作指引。响应闭环各类问题10余项;熟练掌握服务打包构建、多环境适配部署等整套交付技能,支撑项目平稳交付。
三、CMDB 平台运营与数据治理
负责 CMDB 数据运营,对接业务方数据写入和查询需求,辅助业务问题排查。承担日常值班工作,并将自助运维经验沉淀为 skills 上架技能广场。负责系统运维,协同排查服务高负载、接口查询缓慢、Kafka 堆积等故障,现阶段保障存量业务稳定,并协助业务迁移至新版 CMDB。
完成 CMDB 智能问数项目落地,参与从内部知识库构建、多轮问数定制化开发调优,到应用服务的搭建上线全流程;以及在大洋电机交付工作中,排查并闭环部署问题 8 项,保障交付进度。
四、InfluxDB 数据库服务化开发
参与 InfluxDB 服务化能力建设,实现实例备份与恢复、父子实例改造、节点重启与变配能力开发,完成 Data 节点迁移调研与前期开发,积累了数据库与容器化开发经验。
自定义线程池
1 | @Bean |
1 | 任务执行流程(必背) |
生产规范:禁止直接使用Executors创建线程池,必须手动new ThreadPoolExecutor,指定有界队列+合理拒绝策略,防止无限任务/线程引发OOM。
参数该怎么合理设置?(业务实战经验)
核心线程数 = CPU核心数 + 1核心线程数 = CPU核心数 * 2 或者 CPU核心数/(1-0.9)ArrayBlockingQueue设置固定容量,根据业务峰值预估,不要用无界队列。CallerRunsPolicy,不丢数据,让调用方限流;DiscardPolicy;AbortPolicy,捕获异常返回业务繁忙。?? 常用使用方式
1 | pool.execute(() -> { |
1 | Future<String> future = pool.submit(() -> { |
1 | CompletableFuture.supplyAsync(() -> { |
Spring Boot 默认线程池
| 类别 | 作用 | 线程数 |
|---|---|---|
| tomcat 线程池 | 处理 HTTP 请求(你的 API 接口就跑在这里) | 核心 10,最大 200 |
| @Async 线程池 | 处理 @Async 注解的异步方法 | SimpleAsyncTaskExecutor(每次新建线程,无复用) |
| @Scheduled 线程池 | 定时任务 | 单线程 |
并发设计 SOP —— 线程池使用规范
portCheckExecutor、cmdbQueryExecutor判断标准:只要两类任务的执行时间量级不同(ms 级 vs 秒级),或 SLA 要求不同,就必须隔离。
1 | // 禁止 |
1 | 提交任务 |
1 | future.cancel(true); |
TimeoutException),但线程池里的任务仍然继续执行,只是结果无人消费。这是 CompletableFuture 与线程池解耦的本质——调用方的取消意图无法传递给线程池。适用:带数据库查询的 Java Web 服务(Spring Boot + Tomcat + 关系型/文档型数据库)
排查顺序总览:① Tomcat 线程 → ② CPU/内存/GC → ③ 外部调用 RT → ④ 数据库连接池 → ⑤ 慢查询 (每步的结论决定下一步的方向
判断:服务自身撑不住,还是在等别人?
| 指标 | 正常 | 危险 |
|---|---|---|
| 最大繁忙线程数 | < max 的 70% | = max(打满过) |
| 当前处理中请求数 | 波动正常 | 持续居高不下 |
| 待处理请求数 | 0 | > 0(在排队) |
根据结果判断:
1 | 处理中线程数高 + CPU 高 → 第②步,计算密集或 GC 问题 |
三个关键参数
| 参数 | 类比标准线程池 | 作用 |
|---|---|---|
min-spare-threads |
corePoolSize | 最小空闲线程数,始终保活,应对突发流量 |
max-connections |
maximumPoolSize | Worker 线程上限 = 最大并发处理请求数 |
accept-count |
队列长度 | 线程满后 TCP 层的等待缓冲,0 = 满了直接拒绝连接 |
1 | RUNNABLE → 等待 OS 调度,可以拿 CPU(计算中) |
1 | Feign 调用 / 等数据库连接 |
CPU 高的常见原因:
| 场景 | 特征 |
|---|---|
| 大对象 JSON 序列化 | RT 高,CPU 持续高,内存同步上涨 |
| 正则/加解密密集计算 | CPU 高,特定接口慢 |
| 线程数过多导致上下文切换 | CPU sys 占比高 |
| Full GC | CPU 出现周期性尖刺,服务周期性卡顿几秒后恢复 |
Full GC导致卡顿的特征:
1 | 内存使用率持续攀升,接近堆上限 |
CPU/内存正常但服务慢(最隐蔽)→ 这种情况监控无告警,唯一证据是 Tomcat 处理中线程数升高:
1 | 线程挂起等待 IO(DB 连接 / Feign 调用 / 分布式锁) |
判断:慢在哪个下游?
查看 APM 中本服务对外的调用耗时,重点对比问题时段 vs 正常时段的 RT 基线:
判断:是连接池耗尽,还是 SQL 本身慢?
| 关键指标 | 含义 | 危险信号 |
|---|---|---|
| active connections | 当前占用的连接数 | 接近 max-pool-size |
| pending threads | 等待获取连接的线程数 | > 0 |
| connection acquire time | 获取连接耗时 | > 0ms(正常应接近 0) |
| connection timeout 次数 | 等连接超时失败数 | > 0 说明已出现获取失败 |
acquire time > 0ms是最早的信号:连接池空闲时获取连接几乎是瞬间的,一旦出现等待,说明连接池在某个时刻已经被耗尽。
| 如何区分 → | 连接池耗尽 | 慢查询 |
|---|---|---|
| acquire time | 飙升 | ≈ 0 |
| 受影响的 SQL | 全部 DB 请求都慢 | 只有特定 SQL 慢 |
| active connections | = max-pool-size | 正常范围 |
| 慢查询日志 | 无(SQL 还没执行就卡住了) | 有记录 |
| 根因 | 连接池设太小 / 有慢 SQL 长时间占用连接 | 缺索引 / 数据量暴增 |
| 指标 | 危险信号 |
|---|---|
| 慢查询数 | 突然增多 |
| 活跃连接数 | 接近 max_connections |
| 锁等待次数 | > 0 |
| 索引命中率 | 突然下降 |
| 根因 | 判断方式 |
|---|---|
| 缺索引 | EXPLAIN 查看执行计划,type=ALL 表示全表扫描 |
| 数据量暴增 | 对比表行数历史趋势 |
| 查询条件不走索引 | 索引字段被函数包裹、隐式类型转换 |
| 锁竞争 | 查锁等待日志,找持锁 session |
| 返回数据量太大 | 分页参数过大、缺 limit |
1 | 根因(任选其一) |
top命令展示的),是整机所有进程的CPU总和,包括内核、MySQL、Kafka、Java应用、Nginx等。top按下大写 P,能看到java进程单独占用的CPU百分比。举例子:4核机器。Java开启8个CPU密集型线程,8个线程竞争4个核,会出现大量上下文切换,整机CPU直接打满。IO‑密集型(等待数据库、网络、Kafka响应):线程大部分时间阻塞休眠,几乎不消耗CPU。
top(定位Java进程PID) → top‑H‑p PID(查看哪些Java线程占用CPU) → jstack(导出线程栈) → 把十六进制TID在线程栈中定位代码 → 定位代码问题;jstat、jmap排查GC情况。1 | top |
1 | # -H 展示线程,-p 指定进程 |
1 | printf "%x\n" 29065 |
1 | jstack 28940 > jstack.txt |
jstat -gc 28940 500 每500毫秒打印一次GC情况,重点观察:YGC、FGC发生频率是否极高;Old区内存快速上涨jmap -dump:format=b,live,file=heap.hprof 28940 导出堆快照,事后使用 MAT 工具分析。第一阶段:判断严重程度(2 分钟内)
1 | # 确认进程 PID |
| O 列 | FGC 增速 | 单次 FGCT | 判断 | 动作 |
|---|---|---|---|---|
| < 80% | 偶发 | < 200ms | 正常 | 观察 |
| 80~95% | 每分钟数次 | 200~500ms | 警惕 | 准备干预 |
| > 99% | 每秒 1~2 次 | > 500ms | 失控 | 立即抓现场 |
第二阶段:抓取现场证据(5 分钟内)
1 | # 先抓线程快照(几乎不影响进程) |
为什么先 jstack 再 jmap:jmap dump 会触发一次 Full GC + STW,可能导致进程短暂无响应,jstack 先拿到不受影响。
第三阶段:分析 jstack(5 分钟)
1 | # 线程总数 / BLOCKED 线程数 |
第四阶段:止血重启
1 | # 复查 GC 趋势 |
第五阶段:事后 heap dump 分析,用 Eclipse MAT 打开 .hprof 文件:
| 步骤 | 操作 | 目的 |
|---|---|---|
| 1 | File → Open Heap Dump | 加载文件 |
| 2 | Leak Suspects Report | 自动分析内存泄漏嫌疑,最快定位 |
| 3 | Dominator Tree | 找占用内存最大的对象树 |
| 4 | Thread Overview | 查看每个线程持有多少内存 |
1 | --- |
线下同步 9.1
“你现在方便吗,想跟你私下聊下我个人的一些规划。
我这边有离职的想法,打算下周提交正式申请。今天先提前跟你同步一声,主要考虑马上有中秋、国庆假期,提前说下后续做好工作衔接。
主要是我自己职业方向上的考量:
第一,经过这两年做运维平台相关开发,我发现自己长期的兴趣,不太想继续深耕运维开发这个领域。(我希望更多往通用后端方向发展,去接触更多分布式、大规模业务系统这类场景,目前咱们团队的业务方向和我长期想要成长的方向匹配度慢慢错开了。)
第二,站在我个人角度,这两年自己的成长节奏没有达到我对自己的期待,所以想出去外部看看新的机会。这个纯粹是我个人的选择,不是团队或者项目的问题。(说实话,我现在在MOPS+CMDB承担的模块职责其实不少,个人也学习了很多。但从成长回报、晋升路径来看,和我个人预期差距比较大。我感觉到了是赛道本身的天花板限制,很难达成我想要的职业成长,也没有办法更好的回报家人。我评估后,决定换个环境,也是对自己的负责)
你一直关心我的学习和发展,我非常感谢。
我现在还没有敲定外部 offer。接下来这段时间,我的重心会放在交接,手上现有的任务我会尽量收尾梳理,后续新的需求就不要再分配给我了。
这件事目前我只跟你讲了,如果有需要我可以先不和其他同事聊,等我正式提交流程之后,我们再同步组里其他同事。”
同步结果 9.1
达成新共识:暂停原计划9月中旬提交离职申请,保留在职状态,不再承接运维开发需求,重心转为基于新CMDB开发智能问数AI Agent项目;领导已知悉我长期有跳槽规划,并无敌意,支持我补齐Java、Spring等底层基础,朝着阿里P6能力标准提升,双方达成默契,待拿到满意外部offer后再正式发起离职流程。
显著利好:能够依托公司平台把原有智能问数方案落地迭代,补齐AI Agent工程化实战履历,同时拥有更充裕的时间打磨项目亮点、补习技术基础,在职收入兜底,规避裸辞风险;唯一潜在隐患是长期处于相对舒适的工作环境,容易放缓投递面试节奏、削弱求职心气,需要持续保持投递与面试节奏,牢记运维赛道薪资与晋升的固有瓶颈,以项目镀金、伺机跳槽为核心目标。
正式申请
交接期间
个人项目总结&收尾&交接
相关材料(离职证明,解除、、、证明)
信息确定(社保交到哪天)
lastday
整体背景:从原有基于阿里 DataAgent 的静态流程问数项目切入,伴随对 Agent 范式、运行时架构、多 Agent 分层的逐步深入,完成三次架构迭代;核心目标是从「配置化流程工具」走向「工程化 Agent 运行时」,强化 AI Agent 的工程设计与落地能力,而非单纯优化问答效果。
| 知识类型 | 规模 | 最佳实现方式 | 是否需要RAG |
|---|---|---|---|
| 概念型知识(别名映射:小机=主机) | 几百条 | 后端内存词典 + 字符串匹配 | ❌ 完全不需要 |
| 枚举型知识(系统枚举:MOPS、CMDB 等系统名、产品名) | 几万条 | 结构化模糊查询接口(like/分词匹配) | ❌ 不需要向量RAG |
当前工作的核心:用内部 Harness 平台做运行时底座,把人工 Workflow 改成大模型动态调度的 ReAct 循环。不是重新发明能力,而是把原有能力重新封装,交给 AI 按需调用。
ps:以下内容还处于设计阶段,未评估,未落地!!
核心设计思想
完整运转逻辑(ReAct 循环)
1 | 用户输入 → 进入 ReAct 循环 |
系统提示词完整设计(直接可用)
1 | 你是 CMDB 智能问数助手,负责解答 CMDB 平台使用问题,以及查询 CMDB 内的资产、配置、系统、部门等数据。 |
MCP 原子能力层设计(按能力域拆分,不按表拆分)
底层 MCP 只做原子能力,不带业务语义,是 Skill 的执行底座。
| MCP 名称 | 能力说明 | 入参 | 核心职责 |
|---|---|---|---|
| mcp_knowledge_dict | 知识查询底层接口 | query | 内部同时处理概念词典匹配 + 枚举值模糊查询,统一返回标准化结果 |
| mcp_get_schema | 表元数据查询接口 | table_name(可选) | 返回表用途、字段、注释、表与表之间的外键关联关系 |
| mcp_execute_sql | SQL 执行接口 | sql | 底层做安全校验(AST 解析、白名单、权限、行数限制),执行查询返回结果 |
| mcp_qa_search | 运维长文档知识库 | query | 向量检索运维手册、故障排查、权限流程等长文本答案 |
关键:查询类就一个通用 SQL 执行 MCP,所有单表、联表、统计都走它,联表逻辑交给大模型根据 schema 里的关联信息生成 SQL,数据库原生做 join。绝对不要一张表一个 MCP,也不要做“资产大类万能查询接口”。
| Skill 名称 | 给大模型的功能描述 | 绑定 MCP | 使用场景 |
|---|---|---|---|
| knowledge_clarify | 业务概念澄清与运维知识问答。当用户使用口语化术语、询问字段含义、平台使用问题、权限问题、报错排查时调用。 | mcp_knowledge_dict + mcp_qa_search | 答疑、术语对齐、概念澄清 |
| get_table_schema | 获取 CMDB 表的元数据信息,包括表用途、字段说明、表之间的关联关系。不确定表结构、字段、关联时必须调用。 | mcp_get_schema | 数据查询前的表信息获取 |
| execute_cmdb_sql | 执行 CMDB 数据查询 SQL,只支持 SELECT 语句。已经确认表结构、生成合法查询语句后调用。 | mcp_execute_sql | 最终数据查询执行 |
设计原则:Skill 数量尽量少而精,3 个核心工具足够。工具越多,大模型选错的概率越高。
关键分流逻辑:不用人工写 if-else 分支,靠三层约束自然分流
安全与兜底设计
求职意向:Java 后端开发、AI 应用工程化
caifengg123@163.com
在这个文档中,我基于工作项目梳理了核心亮点,包括链路梳理、架构设计、业务思考、技术细节和各种衍生,以及对应的问答思路。 基于这些材料,以及下面我将提供旧版的简历内容,结合我在括号中标注的所有优化要点,贴合真实工作场景打磨内容,修正夸大表述、强化运维产品思考、业务痛点拆解、关键技术选型、稳定性保障、客户交付及 AI 项目差异化亮点,量化成果、补齐技术细节,埋好问题“钩子”引导面试官发问,适配后端面试场景,生成完整版精准优化简历。 保留原始的层级、分点、句式结构、排版格式,只对每一条内容做精细化优化,不动任何结构、序号、标题、层级,直接在对话中输出。 以下是简历内容: xxx
自我介绍。
“您好,我叫蔡枫,本科是华南理工大学网络工程专业,2024 年毕业,目前在美的集团做 Java 后端开发,有两年左右的工作经验。
我现在的工作主要有三个方面。
第一块是 MOPS 自动化运维平台,主要负责网络和备份模块,包括 F5 网络自动化、防火墙策略批量下发、NBU 备份自动化,同时也参与 ToB 私有化交付。在这个过程中我比较多地接触到了企业级 Java 后端开发、结合 AI Coding 完整闭环需求。
第二块是 CMDB 资产配置平台。我目前是这个系统的管理员,主要负责业务方数据接入、线上问题和系统稳定性。因为 CMDB 本身是比较复杂的微服务系统,所以这块让我积累了比较多线上排障、数据链路梳理以及 JVM、中间件相关的问题处理经验。
最近我比较重点投入的是 Agent 方向。我参与了基于 CMDB 数据的智能问数 Agent 1.0 的业务落地,主要是基于 DataAgent 做 NL2SQL、Prompt、知识库和上下文等能力;现在正在推进 2.0 的重构,希望从原来的 Graph/Workflow 模式进一步往 Harness、Tool/Skill、ReAct 以及 Agent Runtime 方向演进。
所以我现在希望下一份工作能够继续发挥 Java 后端和工程化方面的积累,同时进一步深入 Agent 应用工程化,尤其是 Agent Runtime、工具编排以及稳定性这一块。”
为什么跳槽?
“过去两年我主要负责内部两套核心底座平台 CMDB、MOPS 的开发与稳定性保障,实际上承担了系统负责人的角色,负责业务迭代和故障运维。
但当前工作更多偏向存量系统的需求迭代与运维支撑,一方面,感觉个人兴趣不在运维平台上面,另一方面,虽然把稳定性做得很好,但在公司的评价体系下,偏维护类的工作可能很难形成可以用于晋升的业务产出。长期下来我感觉到个人成长触到了天花板。
我已经具备需求落地、线上问题治理的能力,希望能够找一个新环境,参与具备业务深度、能够产生技术沉淀的场景,或者有新兴技术、如 AI 应用工程化这类有挑战的场景,产出更有重量的技术成果,进一步把自己的技术深度往上推。
我也十分年轻,有信心尝试不同的领域;持续学习,保持好奇。”
“天花板具体是什么?突破什么?那你在原来的岗位,就不能做这些深度改造吗?”
“客观看,我在现有团队已经可以独立扛下整套平台的全生命周期,从功能开发、迭代的负责,到线上故障排查。但目前业务形态以存量运维底座为主,大部分精力花在把业务方(系统运维)的需求转换为功能,并且要保障系统不出问题。(技术上已经整体掌握了;业务上,一直在做历史债务+需求堆积,而非技术导向)
这类工作的价值是稳,但很难产生新的业务成果。公司晋升评价更偏向新业务迭代类产出,所以在这套体系下我很难拿到向上的机会。
我不希望一直停留在‘保障旧系统稳定’这个层面。我希望能够接触真正有业务深度、或者大模型工程落地的场景,去做架构层面的思考与落地。我希望把我现有的后端、云原生、运维开发的综合能力,放到更大规模的业务场景里,沉淀真正有影响力的技术产出,这也是我选择出来看机会的主要原因。”
“所在的团队和系统,目前还在自动化的构建中,在智能化方面的投入较少。整体业务优先级偏向维稳,大规模架构重构、新形态业务落地的机会不多,资源和业务导向决定很难做大规模的技术产出。””
你觉得你最大的优势是什么?(承接跳槽理由,顺势输出能力 + 潜力)
“一方面,我有完整平台从开发到线上运维的实战经验,能兼顾开发和运维视角,处理复杂线上问题;
另一方面我希望跳出纯维护的定位,愿意去啃高并发、AI 工程化这类比较新的难题,希望在新业务场景把能力进一步放大。”
看过源码吗?fastjson?
AI的使用,AI工作流(极海题库:https://bitfree.cn/question)
我的工作流就是将人类的战略思维(Strategy)与AI的战术执行(Tactics)分离。我负责定义‘做什么(What)’和‘为什么(Why)’,而AI负责‘怎么做(How)’,并通过 Hook 和 Review 机制确保结果的可控与高质量。
我做 AI coding 不是简单让 AI 生成代码,而是一套 Agent 化的工程开发流程。
首先我会前置统一 AI 编码规范(中文回答,生成注释,,)、梳理项目(先让 AI 读当前项目的技术架构、、异常处理逻辑)、注册好各类开发工具能力(Skills,MCP)。然后对于当前需求(readme.md),通过 Brainstorm 做需求发散、通过 Plan 做结构化拆解(拆分功能点P0P1P2,按模块拆分功能实现,各个模块各自开发??阶段性完成后进行测试,通过后再开发后续模块??)。在开发阶段,我采用主 Agent 调度 + 多专家子 Agent 并行开发的模式,主模型负责评审和把控质量,轻量化子模型负责具体代码编写,兼顾质量和效率(主模型用好的,贵的)。最后统一生成单元测试、做代码评审和联调,实现标准化、高质量、可落地的 AI 编码闭环。
如何保证AI Coding代码质量?
AI 写完必须过 AI 评审 Agent
专门检查:
并发隐患
空指针风险
事务失效场景
SQL 全表扫描
参数未校验
重复代码、坏味道
AI开发中对SDD的理解
“总而言之,SDD 不仅仅是一个开发流程,它更是一种工程思维的转变。它标志着我们从‘凭感觉编程’(Vibe Coding)进入了‘按规范交付’的工程化时代。对于后端开发者而言,掌握 SDD 意味着我们不再是 AI 生成代码的被动接收者,而是通过定义清晰的‘契约’,主动地、系统性地驾驭 AI,确保交付的软件既正确又符合业务意图。这正是在 AI 时代,后端工程师核心价值的体现。”
AI coding如何节省Token?
核心:少输入、少输出、少交互、精上下文
面试回答:原则 + 6个具体方法 + 总结价值
亮点:体现你会用 AI、懂成本、有工程规范
AI CODING L1,L2,L3??
现在大模型能力越来越强,你觉得程序员会不会被替代?程序员核心竞争力是什么?
AI不会替代程序员,但是会淘汰只会机械编码、不会驾驭AI的人;未来竞争不是人对抗AI,而是会用好AI的程序员,和不会使用AI的程序员之间的竞争。
Agent

Agent如何节省Token?
架构上,用Skill封装替代链式Tool调用,从根源上减少交互轮数;并设计模型路由,让大模型只处理复杂任务。
上下文上,通过摘要压缩历史对话,使用‘山顶洞人’模式精简输出,并极致优化提示词。
交互上,利用KV Cache避免重复计算,在多Agent场景下采用Latent Briefing技术进行高效通信。
基建上,部署语义缓存来拦截高频重复问题。
LLM相同,提词相同,输出结果一定一样吗?
结论先说:默认情况下一定不一样;只有严格锁死全部条件,才能做到每次输出完全相同
Skills?
“简单来说,Agent Skills 就是AI的标准化岗位说明书。它通过 SKILL.md 文件将领域知识、操作步骤和脚本封装起来。最巧妙的是它采用了渐进式披露机制,只在需要时才加载详细内容,既保证了效果又节省了 Token。如果说 Tool 是 AI 的手和脚,那 Skill 就是 AI 的‘肌肉记忆’和‘工作经验’。在2026年,构建高质量的 Skills 库是企业级 AI 应用落地的关键。”
cf:skills提供业务知识,让llm从普通员工→该业务的资深员工,区别于预设好场景提前设计好Prompt模板供模型使用,Skills让LLM能按需自行构造Prompt?!
RAG?落地?
如何基于知识库设计一个 AI问答系统?
Harness?
AI 技能体系
三大原则:强调项目业务价值、标准项目叙事结构、预埋知识点引导面试官提问,主动导向自身准备充分的技术栈。
如何把项目讲好?细节?
1 往岗位需求上倾向(包装)
2 具体怎么展开?为什么做(背景,不要说“老板要做的”),核心问题(一两个难点、如何解决),惊喜(额外思考、解决了什么)
3 面对质疑:好问题(您提出了一个稳定性/架构层面的问题),可能当时没考虑到,而是在聚焦别的问题。。未来可以。。
“挑一个你做得比较有代表性的项目讲一下”
“如果从后端技术挑战来说,我来讲一下 MOPS
一方面,有基本的、完整的需求落地、闭环经验,,有实际的效果
一方面,针对经典运维场景有深度优化。。我比较想介绍一下防火墙策略批量下发这个项目,因为里面涉及任务调度、并发控制、长耗时 IO、幂等以及异常恢复,这块我参与得比较深。”
“当时主要的问题是防火墙策略批量下发。其中单策略耗时就导致整体异常,,
原来的实现是多节点定时任务调度,任务执行过程中存在重复触发的问题,同时大量策略下发属于长耗时 IO,如果串行执行,单批次效率比较低。
所以我主要从任务互斥、执行正确性和执行效率三个方面做了调整。
第一层是通过 Redis 分布式锁控制多个节点之间的任务互斥;
第二层是在数据库侧增加 CAS 和 EXECUTING 中间状态,作为任务执行状态的最终约束,避免因为调度层异常导致同一个任务被重复执行;
第三层是把长耗时 IO 放到专用线程池里并行执行,同时增加失败重试、超时控制以及僵尸任务巡检。
最后单批次下发效率提升了大概 4 倍,策略重复下发率降到了 0。”
“我当时考虑的是,这两个东西解决的问题其实不完全一样。
Redis 锁主要解决的是调度层面的互斥,尽量避免多个节点同时拿到任务执行权。
但是 Redis 锁本身更偏向于控制执行过程,如果发生锁过期、节点异常或者任务状态变化,仅靠 Redis 很难保证数据库里的最终状态一定正确。
所以数据库侧我又增加了 CAS 和 EXECUTING 状态,相当于把数据库作为最终的一致性约束。
所以简单来说就是 Redis 负责减少重复执行,DB CAS 负责最终的执行正确性。”
一个挑战。
“比起 MOPS 的平稳迭代,更大的挑战是 CMDB 原来的负责人交接给我时,团队中的其他成员对其代码实现了解不高,而且故障多。。
今年,我逐渐接手了这个系统,后来主要负责业务方的数据接入、线上问题以及日常维护。因为它本身是一个比较复杂的微服务系统,所以我后面花了比较多时间把核心数据链路梳理清楚,包括数据接入、同步、MongoDB 存储、Redis 元数据缓存等。”
“CMDB 这块我的角色更多是系统 Owner 和线上维护,不是最初架构的设计者。我比较深入的是核心数据链路、问题定位和线上稳定性。比如业务接入出现问题时,我需要从接口一直追到数据同步、数据库以及缓存这一层,定位到底是哪一层出了问题。”
“你简历里 Agent 是怎么做的?”
“这个项目其实经历了两个阶段。1.0 更偏传统的 Workflow/Graph 编排,2.0 我们现在正在往 Agent Runtime 的方向重构。”
“1.0 是基于阿里开源 DataAgent 做的运维场景定制,核心任务是让用户通过自然语言查询 CMDB 数据。我们主要做了表召回、SQL 生成、Prompt 调优、知识库以及基础多轮上下文。”
“2.0 的思路发生了比较明显的变化。原来是人工把 Graph/Workflow 定义好,让模型在预设流程里执行;现在希望把这些业务能力拆成 Skill/Tool,由 LLM 根据当前上下文动态决定调用哪个能力,Harness 负责会话、上下文以及运行时约束。”
“所以我现在比较关注的,是怎么让 Agent 在真实业务环境里稳定运行。”
为什么你一个 Java 后端想做 Agent?
“我觉得 Agent 对我来说并不是完全跨领域转行。
我原来做 Java 后端,比较多解决的是确定性系统的问题,比如任务调度、并发控制、数据一致性、异常恢复和线上稳定性。
现在 Agent 引入了 LLM 以后,系统的决策变得不完全确定,但它依然需要解决很多工程问题,比如上下文管理、工具调用、超时、重试、状态管理和异常恢复。
所以我比较感兴趣的是把原来的后端工程能力应用到 Agent 上,让模型能力真正变成一个稳定可运行的业务系统。”
一次排查问题。
先止血,后排查。。(快速定位影响面和故障类型,对应获取证据,定位根因)
cpu飙升,发现是一个接口有io操作,并发大了就卡住了。。
首先,停掉回写接口,把cpu降下来,恢复服务
分析,不是计算型的,所以多线程没用,要考虑优化io查询,cmdb加索引。。
其次,如何降低并发,加缓存?异步??
处理偶现问题
技术亮点与难点
分布式,高并发,,,??
“你了解高并发 / 秒杀如何设计?”
在我们运维平台项目中,没有电商秒杀这种瞬时热点争抢资源的业务,但是项目中大量用到高并发相关基础组件。
比如 MOPS 大批量下发任务用到线程池异步、接口限流;CMDB 大批量资产入库用到 Redis 缓存优化、upsert 幂等、Kafka 异步事件。
针对秒杀这类场景,我学习过整套处理思路:
前端请求层做限流削峰,Redis 预减库存挡大部分流量,MQ 异步解耦下单流程;通过请求 ID 做下单幂等;利用分布式锁防止库存超卖;同时设计熔断降级保障核心链路;最后数据库做最终一致性校验。
我们运维场景没有资源抢占,更多是大批量平稳同步,不会出现热点 Key 争抢的情况。
Q&A(doubao文档 https://www.doubao.com/docx/LBf3d5HhDo1GbBxiSpucIhmDnbb)
MOPS 是集团核心自动化运维平台,主要承载集团主机、网络、存储等模块的日常运维任务执行工作,替代传统人工登录设备、配置策略的低效模式,实现运维工作标准化、自动化、闭环化。
我作为网络与备份模块核心负责人,全程负责需求对接、方案评审、功能落地闭环,平台稳定性治理,以及外部私有化定制交付全流程工作。我们的核心工作,就是把高频、重复、高危的手工运维动作,通过业务模型&流程设计、结合代码实现的方式固化为平台自动化能力。
整体而言,这个项目让我跳出单纯的功能开发,完整沉淀了业务抽象、需求治理、工程优化、团队协同、客户交付、AI 能力融合的综合落地能力,擅长把繁琐的业务流程转化为标准化、自动化、可兜底、可交付的工程能力。
Q0:你在 MOPS 平台主要负责什么?核心解决了什么业务问题?
我主要负责 MOPS 平台F5 网络自动化、NBU 备份自动化两大核心模块的全栈落地与运维交付,同时承担对内需求治理、团队方案推进、对外私有化定制交付工作。
核心解决两大业务痛点:第一,集团传统网络、备份运维高度依赖人工,高频工单重复操作多、效率低、人工误操作风险高;第二,人工变更无标准化流程、无记录、无回滚机制,一旦出错排查成本极高;
我通过将手工运维动作固化为平台自动化能力,实现了运维流程标准化、执行自动化、风险可兜底、能力可交付,大幅提升集团运维效率,降低线上变更风险,同时支撑外部客户定制化交付。
Q1:讲一讲MOPS平台F5自动化策略下发的整体设计,有哪些核心思想?
Q2:项目中用到了线程池、异步优化,具体是什么场景?解决了什么问题?
Q3:介绍下 MOPS 防火墙策略定时下发的调度方案,线上遇到过什么核心问题?如何解决的?
这里可以自然预埋引导:当时改造的时候我也意识到,单纯靠 Redis 分布式锁是无法做到 100% 正确性,一旦 Redis 发生故障,锁机制直接失效,必须要有数据库层面的兜底防护。
1 | List<CompletableFuture<FirewallSecurityRulePO>> futures = rules.stream() |
1 | lockAcquired = lock.tryLock(0, LOCK_LEASE_TIME_SECONDS, TimeUnit.SECONDS); |
1 | finally { |
衍生预埋点:这里我做设计的时候特意区分了分布式锁的定位,它是性能优化手段,不是正确性的最终保障。分布式锁只能规避正常情况下多轮任务并发跑,一旦Redis宕机、网络抖动,锁机制会失效,不能依靠锁保证策略不重复下发,真正的正确性防线必须下沉到数据库层面。
1 | boolean preOccupied = firewallSecurityRuleService.updateToExecuting(rule); |
Q4:你说你负责需求把控和团队方案落地,具体做了什么工作?
MOPS 承载全集团运维工单,需求零散、场景琐碎、业务方诉求不统一,如果盲目迭代会导致功能冗余、逻辑混乱、难以维护。我在团队中主要承担需求收敛、方案标准化、落地推进的工作:
第一,日常对接网络运维团队,收集零散工单需求,梳理共性场景,过滤无效需求,将个性化诉求沉淀为标准化通用功能,避免重复造轮子;(如基于F5的负载均衡和域名解析能力建设,有许多共同点,协助外包同事,参考已落地的DNS一键回退能力,快速开发负载均衡一键回退功能)
第二,针对复杂运维场景,牵头拆解技术方案,统一团队开发规范,协助新人拆解任务、梳理执行逻辑,保障团队迭代节奏统一;(如DNS策略采集,涉及多项目协同,CMDB → MOPS-Job → ansible调度 → MongoDB写入)
第三,把控迭代优先级,区分紧急故障修复、日常功能迭代、长期能力建设,保障平台稳定优先、迭代有序。
这让我具备了从「纯开发编码」上升到「业务理解+需求治理+团队协同落地」的综合能力,能够站在业务视角做技术建设。
第四,,,讲经验型、重复类工作梳理skills,利用AI赋能。。。
Q5:(todo)NBU 自动化下发怎么做的?
ssh+公秘钥,实现登录远程机器
ansible+api,亮点是。。效果是。。
Q6:讲讲你私有化对外交付的工作内容,遇到过什么难点,怎么解决的?
我负责 MOPS 平台私有化项目的定制化需求交付、客户对接、问题全闭环工作。和对内迭代不同,私有化交付需要完全贴合客户现场环境、适配客户个性化运维流程,同时需要全程对接客户、答疑、处理适配问题,交付闭环要求极高。
除了系统的部署,一个功能要用起来,还要把用户环境的设备纳入进来。例如WindowsDNS策略下发,首先要把DNS设备托管(目标机器B上创建运维账号,特权机A免密登录:A发起ssh连接 → B取公钥加密随机数 → A用私钥解密后返回 → B校验解密正确通过认证 → A 在 B上 sudo -u root 执行任务),适配设备环境来改造脚本(先检查DNS角色是否安装,变更前检查记录是否已存在或不符合预期,变更后验证是否正确),设备信息录入CMDB&MOPS配置表。最终自动化全流程打通。
核心难点:客户现场运维流程、设备环境和集团内部不一致,存在大量定制化适配需求,且客户对平台稳定性、操作安全性要求极高。
我的落地做法:前期充分对齐客户流程,梳理定制化适配清单,区分通用能力和私有化专属能力;中期迭代过程中同步适配环境差异,完成功能定制、兼容性测试;后期全程跟进交付验收、问题答疑、故障兜底,保障项目顺利交付。
技术方面,熟悉了k8s云原生环境开发、出包、部署的全流程。
这份工作让我积累了成熟的 ToB 产品交付思维,懂得平衡通用化与定制化,保证产品可落地、可验收、可运维。
Q7:产品私有化输出——运维手册
Q8:MOPS 并发不高,你觉得你的技术亮点在哪里?怎么体现你的工程能力?
Q9:如果让你优化现在的 MOPS 平台,你会从哪些方向入手?
Q10:AI、AIOps相关能力落地
Q11:讲讲你在云原生部署、容器化交付方面的落地能力与思考?
Q12:你们 MOPS 是 ToB 吗?运维产品定位?技术上关注什么?
MOPS/CMDB 首先是集团内部运维中台工具,服务公司内部 IT、运维、开发人员;同时产品做了商业化改造,可以私有化部署交付给外部企业客户,属于 To‑B 私有化软件,没有面向 C 端个人用户。
MOPS + CMDB 整套运维体系是「资产数据底座 + 自动化操作平台」的双层闭环架构,覆盖企业运维「数据可信、操作可控、流程自动化、故障可追溯」的全链路能力,是标准化运维产品的核心基建。
Q13:讲讲MOPS线程池满导致接口pending的故障排查、根因与优化方案
我处理过MOPS线上P2级线程池耗尽故障,核心是线程池设计不合理导致业务接口饿死,沉淀了Java线程池架构设计、故障排查、性能优化的工程实战能力。
Q14:为什么需要手动开启Tomcat MBean监控?有什么工程意义?
线上曾出现Tomcat线程池打满、接口阻塞但无监控告警的问题,核心原因是Spring Boot内嵌Tomcat默认关闭MBean注册,无法暴露线程池、连接数、请求耗时等核心指标,导致服务可观测性缺失。
一、问题根因
Spring Boot约定优于配置,内嵌Tomcat默认不向JMX注册MBean监控节点,监控探针无法抓取Tomcat运行指标,线上线程耗尽、连接溢出等故障无法提前预警,只能被动等待用户反馈故障。
二、解决方案与落地链路
在application.yml开启tomcat.mbeanregistry.enabled=true,触发自动装配机制,让TomcatServletWebServerFactory自动注册MBean到JVM,监控平台通过JMX Exporter定时抓取指标,实现线程活跃数、连接数、请求异常率、耗时等数据可视化。
三、工程核心价值
1 完善可观测体系:补齐Web容器层监控,实现应用层、容器层、业务层全维度监控;
2 故障前置预警:提前感知线程池满载、连接堆积、请求超时等隐患,实现从被动救火到主动预警;
3 性能调优依据:通过监控指标精准优化线程池参数、限流阈值,让调优有据可依。
Q15:讲讲MOPS慢SQL排查与索引优化实战(35万数据量级)
我针对MOPS备份任务查询接口慢查询问题,完成全链路SQL优化,解决35万数据量级下的全表扫描性能瓶颈,沉淀了MySQL索引优化、查询语句重构的实战能力。
项目介绍
CMDB 是美的集团 IT 基础设施统一资源底座平台,集中纳管全网服务器、网络设备、业务应用等全量 IT 资产,核心为 MOPS 运维平台等上层业务系统,提供可信、统一、稳定的资产元数据支撑。集团拥有上万台服务器,覆盖复杂制造业运维场景,CMDB 的稳定性和数据准确性,直接决定了上层运维业务的落地效果。
我作为 CMDB 项目核心业务 Owner,核心工作聚焦全链路架构吃透、保证核心功能稳定性、重大故障闭环,日常负责内外部用户答疑,对接各业务方的数据接入、系统运维和稳定性治理工作。
【预埋引导话术,自然穿插】整套系统混合使用 MongoDB、ES、Kafka,在实践中能明显感受到文档数据库在强事务场景存在短板,这段时间我也系统深入学习 MySQL InnoDB 索引、事务、锁相关理论,对比两类数据库适用场景差异。
Q0:CMDB 核心读写链路设计
1 | // NX:key 不存在才设置(互斥,保证只有一个拿到锁) |
1 | -- 逻辑:只有锁的值等于当前自己的uuid,才删除,避免误删别人的锁 |
Q1:CMDB 本质是一套资产数据读写服务,你在日常负责过程中,从架构稳定性角度,如何保障数据可信、接口稳定可靠?
CMDB 作为集团运维领域的根数据源,它的核心本质并不是简单的增删改查接口,而是持续稳定输出可信资产数据、服务长期稳定、链路全程可控。我作为平台管理员,不只是做功能使用与问题救火,更多会从架构稳定性视角,围绕写入管控、访问防护、故障兜底、长期治理四个维度去做持续性优化与思考。
Q2:谈谈 CMDB 整体微服务架构体系、流量链路与服务拆分的设计思想?
CMDB 整体基于 SpringCloud 微服务架构 搭建,是一套分层清晰、职责单一、能力解耦的企业级资产底座架构。我在日常运维、问题排查、功能支撑过程中,完整梳理了平台流量链路与各核心微服务的职责边界,也理解了团队架构拆分的核心设计思路。
Q3:讲讲CMDB基于Monstache实现MongoDB→ES全文检索,整体设计、核心亮点、故障排查思路
业务痛点:MongoDB文档库擅长字段灵活扩展,但做跨文档、多字段模糊/全局检索性能很差,无法满足运维侧全局IP、主机名快速检索需求,因此引入ES做全文检索,用Monstache完成MongoDB到ES的数据同步。
Q4:讲下 CMDB 数据订阅整体架构,为什么选用 MongoShake,而不是原生 ChangeStream 程序直接消费?数据订阅服务消费一条 Kafka 消息完整处理流程?
Q5:详细描述防火墙自动采集整条链路,线上遇到过哪些典型问题?
Q6:平台查询接口响应很慢,你的标准化排查 SOP 是什么?
Q7:线上 Java 服务频繁 FullGC、出现 OOM,你的完整排查流程?
Q8:CPU 高怎么查?
我排查 Java 服务 CPU 高,遵循从机器→进程→线程→代码 / GC 的顺序:
第一步先用 top 看整机 CPU,区分用户态 us、内核态 sy、IO 等待 wa。us 高基本是应用侧问题;sy 高偏向系统调用、上下文切换;wa 高是 IO 瓶颈,不是 CPU 本身忙。
第二步找到 java 进程 PID(这里讨论 us 高来源 Java服务的情况),用top -H -p PID查看进程内线程,拿到高 CPU 线程的十进制 TID,转成 16 进制。
第三步,故障现场同时采集 jstack 线程栈 + jstat GC 指标,两个维度判断: 如果 GC 指标看到频繁 YGC/FGC,就是 GC 消耗 CPU,后续 dump 堆用 MAT 分析内存泄漏; 如果是业务线程占 CPU,拿 16 进制 TID 去 jstack 检索对应栈,定位代码,大概率是死循环、密集计算、正则回溯这类 RUNNABLE 的代码。
这里要区分:死锁不会导致 CPU 高,死锁线程阻塞不占用 CPU;只有持续 RUNNABLE 的循环代码、GC 线程才会持续占用 CPU。IO 阻塞线程会休眠,不耗 CPU。
Q9:Kafka 消息堆积一般怎么分析、如何解决?
Q10:讲讲Linux机器磁盘占用过高的排查SOP与长效优化方案
Q11:私有化交付遇到 ZooKeeper 集群无法启动,完整说下排查过程和解决方案
现象:容器环境重启后 ZooKeeper 集群启动失败,节点无法互相通信;
根因:集群配置文件硬编码节点物理 IP,容器重建之后 IP 发生变动;
手工处理:创建版本化配置文件
解决方案:选择集群健康运行窗口期执行 reconf 动态更新集群配置,用内部域名替换固定 IP;
亮点:方案无需停机重建集群,不存在业务中断;
拓展思考:云原生容器环境部署中间件,应当尽量规避写死 IP,优先使用域名、服务发现机制。
Q12:重大故障——详细说说CMDB内存Swap抖动OOM的case
凌晨三点,我在生产环境错误操作,导致CMDB data-center服务P1级内存故障——核心是Linux Swap抖动引发的服务OOM崩溃,全程沉淀了系统内存调优、JVM参数配置、线上故障止血的高阶实战能力。
Q13:讲讲CMDB MongoDB实例异常重启故障的排查思路与索引优化落地
我处理过MongoDB节点无故崩溃重启的线上故障,通过日志溯源、慢查询分析、索引优化,彻底解决数据库实例稳定性问题,沉淀了MongoDB性能调优与故障排查能力。
Q14:CMDB Kafka偶发性消息堆积的根因分析与治理方案
线上出现每周定时Kafka消息堆积的规律性故障,我通过流量分析、消费能力校验,定位瓶颈并完成轻量化治理,保障采集链路稳定运行。
Q15:CMDB微服务视图卡顿、Tomcat线程打满故障排查与治理
针对CMDB对外数据访问服务接口卡顿、500报错问题,我沉淀了Tomcat线程池监控、服务链路排查、上下游定位的标准化排查能力。
Q16:接口突然不可用?CMDB全文检索ES偶发500故障
我处理过ES检索接口偶发500的疑难故障,突破常规日志排查思路,精准定位依赖版本冲突的隐性问题,掌握中间件客户端适配、版本兼容治理能力。
Q17:介绍下你的内网IT故障排查Skill?
1 | --- |
Q18:如果让你重新设计整套 CMDB 底座,你会做哪些优化?
Q19:CMDB 大量选用 MongoDB,为什么初期没有选择 MySQL?你如何对比两种数据库?
选型原因:平台资产类型繁杂,不同设备属性差异大,需要频繁新增扩展字段;MySQL 频繁执行 DDL 修改表成本很高,MongoDB 文档模型可以灵活扩展字段,适配业务场景。
客观短板:MongoDB 不适合强事务、多表复杂关联的交易场景。
主动过渡话术:如果是订单类核心业务系统,MySQL 会更加合适,事实上我对 Mysql的学习更加深入(有服务化数据库开发经验),我近期系统学习 InnoDB MVCC、锁机制、索引优化等内容,能够胜任关系型数据库相关的开发与调优工作。
项目定位:基于阿里开源 Spring AI Alibaba DataAgent 二次开发,面向运维资产场景打造的轻量化智能问数 Agent。解决传统 CMDB 查数门槛高、需写SQL、依赖运维经验的痛点,支持用户通过自然语言直接查询、分析、统计运维资产数据,实现「自然语言→智能解析→精准查数→结果反馈」的端到端智能化能力,是传统运维平台向 AI 智能化升级的核心落地项目。我全程负责Java后端工程改造、Agent工作流架构优化、RAG检索定制、流式交互、模型热更新等核心AI工程化落地工作,重点深耕Java与AI结合的工程实战,而非单纯算法调优。
迭代经历
3分钟标准项目口述文稿(以下内容来自问数 1.0,以及问答 Q1~Q11 都来自问数 1.0)
CMDB-Agent 智能问数项目,是我基于 Spring AI Alibaba 开源 DataAgent 二次迭代的运维领域智能化项目,核心目标是降低集团CMDB资产数据的查询门槛,让无SQL基础、无运维经验的员工,可通过自然语言直接查询、统计、分析上万台设备的资产数据,实现运维查数智能化、轻量化。
项目核心难点在于,大模型原生输出具有概率性、不可控性,直接端到端调用极易出现 SQL 错误、语义偏差、脱离运维业务场景的问题;同时通用RAG检索无法适配运维资产枚举类、术语类专属场景,存在漏召回、语义稀释的痛点。针对这些问题,我聚焦AI工程化落地、Java架构适配、场景化能力优化,完成了五大核心技术改造,全程规避纯算法短板,突出后端工程落地能力。
第一,我基于 Spring AI Graph 搭建DAG 原子化工作流架构,彻底解决大模型输出不可控问题。将原本端到端的问答流程,拆解为意图识别、证据召回、查询增强、SQL规划、SQL生成、语义校验、数据执行、报告生成等独立原子节点;每个节点通过结构化Prompt、固定输出格式、Java代码约束压缩模型自由度,同时配置Dispatcher动态路由,实现SQL失败重生成、规划不合理重试的容错闭环,极大提升问答准确率与系统可控性。同时支持分支、循环、故障重试,相比传统线性流程稳定性大幅提升。
第二,实现全链路流式交互架构,优化用户体验与实时反馈能力。基于 Spring WebFlux 响应式编程,贯通从LLM流式响应、Graph节点流式执行到SSE前端推送的完整链路,所有节点均以Flux为输出载体;同时自定义文本类型状态机,区分SQL、Markdown、推理日志、表格数据四类流式内容,前端差异化渲染展示。并且实现线程安全的主动断连、资源释放机制,避免流式请求堆积造成的内存泄漏。
第三,落地模型懒加载+无重启热切换工程能力,解决传统模型配置更新需重启服务的痛点。通过Spring AOP动态代理、自定义TargetSource实现Embedding模型动态委托,结合FactoryBean模式封装流式/阻塞式模型调用策略;通过比对数据库配置更新时间,结合ConcurrentHashMap缓存实现ChatClient懒加载、自动淘汰,支持DeepSeek、Qwen等多模型动态切换,无需重启服务,大幅提升运维迭代效率。
第四,定制运维场景专属混合RAG检索架构,解决通用检索适配性差、漏召回问题。采用向量检索+关键词检索并行执行、RRF算法融合的混合检索方案,同时针对运维业务特性,将知识库拆分为实体枚举类、规则映射类两类数据,差异化配置召回参数与检索策略;通过LLM提取实体关键词,联动数据库精准模糊匹配,解决向量语义稀释导致的枚举值漏召回、术语不匹配问题,大幅提升查询语义匹配度。
第五,设计轻量级多轮对话管理机制,实现会话无缝续接与低损耗交互。采用内存滑动窗口机制缓存核心对话摘要,不冗余存储完整上下文,降低Token消耗;冷启动时自动从数据库恢复历史会话状态,将上下文信息注入各节点Prompt,保障多轮问答的语义连贯性,同时规避大模型上下文过长导致的性能衰减与成本问题。
整体项目完全聚焦后端AI工程化落地,不依赖算法调优,通过Java架构优化、工作流约束、检索策略定制、流式能力改造,实现了大模型在企业运维场景的稳定、可控、可用落地,补齐了我Java高阶工程、AI应用开发、响应式编程、动态代理架构的实战经验,也是我区别于普通CRUD开发的核心技术亮点。
Q1:你为什么要基于Graph图流程拆解问答链路?核心解决大模型什么问题?
核心解决大模型概率性输出不可控、黑盒难容错、错误无法定位的行业通用痛点。传统端到端问答,模型一次性输出所有内容,极易出现SQL语法错误、语义偏离业务、逻辑漏洞等问题,且无法精准定位出错环节、无法自动修复、难以迭代优化。
我通过DAG有向无环图将复杂问答拆解为多个单一职责的原子节点,每个节点只负责一项任务,通过Java代码+结构化Prompt严格约束输出格式:意图识别仅做二分类、规划节点仅输出规范JSON、SQL节点仅负责语句生成、专属节点做SQL审计校验。
同时搭配Dispatcher动态路由,形成完整容错闭环:SQL校验失败自动重生成、规划不合理触发重试、参数异常自动兜底,将大模型的不确定性,通过工程架构手段转化为可控、可观测、可修复的稳定能力,这也是企业级AI应用落地的核心关键。
Q2:讲讲你全链路流式输出的技术实现,用到了哪些核心技术?
整套流式架构基于Spring WebFlux + Reactor + SSE实现,是典型的响应式编程工程落地,贯穿整个Graph工作流:
Q3:模型热切换、懒加载的核心实现思路是什么?解决了什么业务痛点?
传统AI项目模型Bean均为容器启动时初始化,模型配置修改、模型切换必须重启服务,迭代效率低、可用性差。我通过Spring高阶特性实现无重启热更新、按需懒加载:
Q4:你的RAG混合检索架构和普通向量检索有什么区别?解决了什么独有场景问题?
通用单向量检索存在严重的语义稀释、枚举值漏召回、业务术语不匹配问题,完全无法适配运维资产场景,我针对性设计了分层混合检索架构:
Q5:多轮对话你是怎么设计的?为什么不直接用大模型原生上下文?
大模型原生上下文直接累加对话,会导致Token消耗激增、推理速度变慢、冗余信息干扰查询精度,我设计了轻量级低损耗会话管理方案:
Q6:讲讲你项目中的容错、降级、修复机制,体现工程稳定性思维
我在项目中搭建了多层级容错自愈体系,彻底解决AI问答随机性高、易出错的问题:
Q7:这个项目最大的技术难点是什么?你是怎么攻克的?
最大难点不是调用AI接口,而是如何通过Java工程手段,约束大模型概率性输出,适配严苛的企业运维场景。通用AI模型自由度过高,极易输出错误SQL、脱离业务口径、生成不符合CMDB资产规范的查询语句,随机性强、生产可用性极低,无法直接落地企业真实业务场景。
我的解决方案是「架构限流+代码约束+数据增强」三层工程闭环方案,完全靠后端架构手段压制模型不确定性:
Q8:你项目中用到了Spring AI Graph,讲讲DAG工作流的核心优势,和普通串行调用有什么区别?
传统AI应用基本都是串行线性调用,流程固化、无容错、无分支、不可控,一旦某一步出错直接整体失败,且无法针对性优化单节点能力。而我基于Spring AI Graph实现的DAG有向无环工作流,是企业级Agent落地的核心架构升级,核心优势有四点:
Q9:谈谈你对AI Agent工程化的理解,你的项目和普通简单调用LLM的AIdemo有什么本质区别?
市面上绝大多数AIdemo只是简单封装LLM接口,单次调用、无约束、无容错、无业务适配,只能做演示无法落地生产。而我的CMDB-Agent是完整企业级AI工程化落地,核心区别体现在工程稳定性、业务适配性、可运维性三个维度:
Q10:项目还有哪些未深入、可优化的点?体现你的复盘思考能力
我目前核心深耕的是AI工程落地、Java架构改造、工作流约束、检索优化、流式交互,还有部分AI进阶能力尚未深入落地,也是后续优化方向,面试可坦诚说明、体现复盘思维:
Q11:如何评价问数效果?
准确率
速度
?
Q12:基于Agent开发平台提供的通用能力,如何重构问数 Agent 2.0?
内网推出Agent开发平台,提供通用harness能力,通过配置Prompt,skills,tools,可以“低代码”、“统一”地实现Agent,(目前在做的事情,还未完整理解内网agent平台)
Q13:不用开源项目/通用平台,用 LLM+Harness+Skills 如何从零自研实现一套 Nl2SQL 系统?即问数Agent 3.0
预研脱离重型框架依赖的通用运维 Agent 方案,采用 Harness 会话管理 + Skill 工具化编排的设计思路,解耦业务能力与流程框架,支持快速扩展运维查询、工单处理等多类子 Agent 能力,形成差异化技术积累。(全手搓,还未开始)
原本设想用 ai coding 实现,来补充模拟电商的高并发场景的技术积累,后来评估暂时不做。
为什么自己实现秒杀系统?
日常工作以内部运维平台开发为主,业务偏向资产配置、自动化流程,较少接触高并发、流量削峰场景。因此自主搭建极简秒杀系统,一方面实践 Redis、消息队列、并发控制等技术;另一方面持续探索 AI Coding 工作流,借助大模型完成需求拆解、接口设计、单元测试、问题调试,沉淀一套标准化开发流程,同时学习优秀开源项目架构思想,补齐高并发系统工程落地经验。
不是主要的工作项目,不引入简历。
我主导了InfluxDB数据库的服务化改造,在数据库管控平台(DataMars)中,建设InfluxDB的“数据库即服务”(DBaaS)能力,解决手动运维数据库效率低、易出错的问题。基于开源Influxdb Cluster,从0到1负责InfluxDB实例的备份恢复、在线变配、节点迁移/重搭等核心功能的调研、设计和开发。
具体工作与关键技术细节
市场竞品对比与成果衡量
在面试中介绍时,你可以遵循“背景-行动-结果-对比”的结构:
• 开头总结:用一句话点明项目核心价值。
• 具体阐述:重点突出你如何解决关键问题,特别是高可用、数据一致性、自动化闭环方面的设计。
• 量化成果:用数据(如效率提升百分比、可靠性指标)证明你的贡献。
• 展现视野:通过提及竞品,表明你不仅埋头编码,更抬头看路,了解行业最佳实践。
口头
谈薪
反问
基本概念
Maven是Apache基金会的开源项目管理和构建自动化工具,使用POM(Project Object Model) 文件描述项目结构、依赖关系和构建配置。
是否专门用于Java?
主要定位:主要用于Java项目
可扩展性:通过插件可支持其他语言(Scala、Groovy、Kotlin等)
生态系统:虽然不限于Java,但在Java生态中最为成熟
核心功能
1 | ├── 依赖管理(Dependency Management) |
Maven依赖的本质
| 内容 | 说明 | 是否必须 |
|---|---|---|
| .class文件 | 已编译的字节码(人类可读的.java源代码文件编译而来) | ✅ 必须,用于运行 |
| pom.xml | 依赖的元数据 | ✅ 必须,用于传递依赖解析 |
| 源代码(.java) | 可选,用于调试 | ❌ 可选,IDE可单独下载 |
| javadoc | API文档 | ❌ 可选,IDE可单独下载 |
1 | // pom.xml中的依赖声明 |
1 | ~/.m2/repository/com/google/guava/guava/31.1-jre/ |
| 命令 | 功能 | 说明 |
|---|---|---|
| mvn clean | 清理项目 | 删除target目录 |
| mvn compile | 编译源码 | 生成target/classes |
| mvn test | 运行测试 | 执行src/test下的测试 |
| mvn package | 打包项目 | 生成jar/war包 |
| mvn install | 安装到本地仓库 | mvn package + 将jar安装到本地 ~/.m2/repository |
| mvn deploy | 部署到远程仓库 | 发布到Nexus/Artifactory |
| mvn clean install | 清理并安装 | 常用组合命令 |
| mvn dependency:tree | 查看依赖树 | 分析依赖关系 |
| mvn spring-boot:run | 运行Spring Boot | 需要对应插件 |
A[clean] –> B[validate] –> C[compile] –> D[test] –> E[package] –> F[verify] –> G[install] –> H[deploy]
mvn compile - 编译阶段相当于:执行 javac 编译源代码
1 | # 实际操作 |
当您运行 mvn compile时,Maven 会:
解析依赖:读取 pom.xml 中的
下载依赖:从远程仓库下载到本地 ~/.m2/repository/
构建依赖图:处理传递依赖
关键点:Maven 管理的这些依赖是已经编译好的 .class 文件(JAR 包),不是 .java 文件。
然后 Maven 会:
编译您的代码:src/main/java/下的 .java 文件
使用依赖:编译时将下载的依赖 JAR 加入 classpath
打包:将您的 .class 文件 + 资源文件打包
todo:那么打包的时候到底保护包含依赖?我自己的源代码编译 .class + 依赖包的 .class ??
mvn package - 打包阶段相当于:根据packaging类型不同,将编译结果打包成可分发的格式(注意:普通mvn package生成的jar不包含依赖!依赖需要单独配置)
1 | <!-- pom.xml中指定打包类型 --> |
打包过程:
1 | # 对于jar包: |
mvn install - 安装阶段mvn install 做了两件事:
1 执行之前所有阶段:validate → compile → test → package → verify → install
2 将当前项目的构建结果安装到本地仓库,安装位置 →
1 | ~/.m2/repository/com/yourcompany/yourapp/1.0.0/ |
1 | # 标准开发流程 |
| 方式 | 插件 | 特点 | 适用场景 |
|---|---|---|---|
| 普通JAR | maven-jar-plugin | 不包含依赖 | 库项目 |
| Fat JAR | maven-assembly-plugin | 包含所有依赖 | 简单应用 |
| 可执行JAR | spring-boot-maven-plugin | Spring Boot专用 | Spring Boot应用 |
| Shadow JAR | maven-shade-plugin | 重命名包解决冲突 | 复杂依赖 |
Spring Boot项目(最常用)
1 | <!-- pom.xml --> |
1 | # 打包命令 |
项目结构
1 | my-project/ |
执行流程
1 | # 1. 清理 + 编译 |
1 | File → Settings → Build, Execution, Deployment → Build Tools → Maven |
症状:点击刷新后,依赖仍然报红
解决方案:
强制刷新:
1 | # 命令行执行 |
-U 参数强制更新快照版本
删除本地仓库:
1 | # Windows |
清除IDEA缓存:
1 | File → Invalidate Caches and Restart |
解决方案:
配置阿里云镜像(settings.xml):
1 | <mirrors> |
IDEA配置镜像:
1 | File → Settings → Build Tools → Maven |
症状:NoSuchMethodError, ClassNotFoundException
排查命令:
1 | # 查看依赖树 |
IDEA可视化排查:
解决冲突示例:
1 | <dependency> |
1 | <!-- 统一管理版本 --> |
| 图标 | 功能 | 快捷键 |
|---|---|---|
| 🔄 | 重新导入所有Maven项目 | Ctrl+Shift+O |
| 🏃 | 运行Maven目标 | 右键→Run Maven |
| 📊 | 显示依赖图 | 右键→Show Dependencies |
| 🧹 | 执行clean | 双击Lifecycle→clean |
1 | <!-- pom.xml 中定义不同环境 --> |
在IDEA Maven工具窗口的Profiles中勾选激活。
当遇到顽固依赖问题时,按顺序执行:
第一步:清理缓存
1 | mvn clean install -U |
第二步:删除本地仓库对应目录
1 | # 删除有问题依赖的目录 |
第三步:IDEA完全清理
.idea 目录和 *.iml 文件第四步:检查Maven配置
1 | # 查看有效POM |
第五步:网络代理检查
1 | <!-- settings.xml 配置代理 --> |
使用依赖锁定
1 | <plugin> |
定期清理本地仓库
1 | # 清理失败下载 |
使用CI/CD环境验证
在Jenkins/GitHub Actions中设置定期构建,提前发现问题。
| 错误代码 | 含义 | 解决方案 |
|---|---|---|
| 501 HTTPS Required | 仓库需要HTTPS | 更新settings.xml,使用https仓库 |
| 401 Unauthorized | 认证失败 | 配置正确的server认证 |
| Could not transfer artifact | 网络/权限 | 检查网络,清理.lastUpdated文件 |
| No compiler is provided | JDK配置错误 | 配置JAVA_HOME,或在pom中指定javac |
离线模式(网络不稳定时)
1 | mvn clean install -o |
跳过测试
1 | mvn clean install -DskipTests |
多线程构建
1 | mvn clean install -T 4 |
调试模式
1 | mvn -X clean install |
📚 文档链接: 快速入门 | Milvus 文档
向量嵌入是从机器学习模型中提取的数值表示,捕捉非结构化数据的语义含义。这些嵌入通过神经网络或变压器架构对数据中的复杂相关性进行分析,创建一个密集的向量空间,其中每个点对应于数据对象(如文档中的词)的“含义”。
这个过程将文本或其他非结构化数据转换为反映语义相似性的向量——在这个多维空间中,意义相关的词被放置得更近,从而实现一种称为“密集向量搜索”的搜索方式。这与依赖精确匹配和使用稀疏向量的传统关键词搜索形成对比。向量嵌入的发展,通常源于大型科技公司广泛训练的基础模型,使得搜索能够捕捉数据的本质,超越词汇或稀疏向量搜索方法的局限性。
向量:可以理解为在多维空间中的一个点,它由一组数字(坐标)表示。在 AI 中,无论是文本、图像还是声音,都可以通过特定模型(如 qwen3-embedding-4b-torch)转换为一个向量。这个向量捕捉了原始数据的深层特征。
维度:就是指这个向量有多少个数字。例如,一个 [0.12, 0.45, -0.23, …, 0.78]的向量,如果它有 1024 个数字,我们就说它是一个 1024 维 的向量。维度的选择通常由您选用的嵌入模型决定,并且在创建 Milvus 集合时必须正确定义,因为所有存入的向量都必须有相同的维度。
非结构化数据(如文本、图像和音频)格式各异,蕴含丰富的潜在语义,因此分析起来极具挑战性。Embeddings 被用来将非结构化数据转换成能够捕捉其基本特征的数字向量。然后将这些向量存储在向量数据库中,从而实现快速、可扩展的搜索和分析。
Milvus 提供强大的数据建模功能,使您能够将非结构化或多模式数据组织成结构化的 Collections。它支持多种数据类型,适用于不同的属性模型,包括常见的数字和字符类型、各种向量类型、数组、集合和 JSON,为您节省了维护多个数据库系统的精力。
与处理结构化数据并执行精确搜索操作的传统关系数据库不同,向量数据库擅长使用 Approximate Nearest Neighbor(ANN)算法等技术进行语义相似性搜索。这种能力对于开发推荐系统、聊天机器人和多媒体内容搜索工具等各种领域的应用程序,以及解决 ChatGPT 等大型语言模型和 AI 带来的挑战(如理解上下文和细微差别以及 AI 幻觉)至关重要。
| Milvus 概念 | 类比关系型数据库概念 | 说明 |
|---|---|---|
| Collection(集合) | Table(表) | 存储向量和关联元数据(如文本内容、来源)的基本单位。 |
| Entity(实体) | Row(行) | 一条完整的记录,包含主键、向量字段和标量字段(元数据)。 |
| Field(字段) | Column(列) | 包括向量字段(存储向量)和标量字段(存储 ID、标签等结构化数据)。 |
| Index(索引) | Index(索引) | 为向量字段建立的索引(如 HNSW、IVF_FLAT),是高速检索的关键。 |
写入数据(以 Python 为例):
1 | from pymilvus import connections, Collection, FieldSchema, CollectionSchema, DataType |
读取与搜索:
1 | # 用户提出问题,并转换为向量 |
Milvus 支持的搜索类型
ANN 搜索:查找最接近查询向量的前 K 个向量。
过滤搜索:在指定的过滤条件下执行 ANN 搜索。
范围搜索:查找查询向量指定半径范围内的向量。
混合搜索:基于多个向量场进行 ANN 搜索。
全文搜索:基于 BM25 的全文搜索。
获取:根据主键检索数据。
查询使用特定表达式检索数据。
Rerankers
在基础的 RAG 流程中,系统通过 Embedding 模型 将用户查询和知识库文档转换为向量,然后利用向量数据库进行快速的相似性搜索,找出最相关的几个文档片段作为上下文提供给 LLM 。然而,这种基于向量相似度的检索有时无法完美捕捉深层次的语义关联,可能返回一些看似相关实则无关的“噪声”文档 。
Reranker 模型的作用就在于此。它通常在向量检索之后介入,像一个专业的裁判,对初步检索到的候选文档(例如 Top 20 或 Top 50)进行二次精排 。其核心工作原理是:
1、精细化语义理解:不同于 Embedding 模型分别处理查询和文档,典型的 Cross-encoder Reranker 会将查询和一个候选文档同时输入模型,让模型直接分析两者之间的交互信息,从而给出一个更精确的相关性分数 。
2、结果重排序:Reranker 为所有候选文档重新打分并排序,最终只将排名最靠前的、真正相关的少量文档(如 Top 3 或 Top 5)传递给 LLM 。
在 RAG 流程中,Milvus 扮演着 知识库与高速检索引擎 的角色。
qwen3-235b-a22b),由它来生成精准、有据可依的最终答案。人工智能集成:
Agentic RAG(智能体驱动的 RAG,Agentic RAG = RAG + Agent):基础的 RAG 中,检索-增强-生成是一次性完成的。而Agentic RAG则引入了“智能体”的概念,智能体可以根据对大模型初步生成内容的理解,主动地、多次地 与向量数据库(Milvus)进行交互。这使 RAG 系统从静态的“文档查找”升级为动态的、具有决策能力的“研究助手”。例如:
AI Agent的本质是能够感知环境、自主决策并执行行动的智能实体。与传统AI系统最大的区别在于Agent具有自主性、反应性、目标导向和学习能力,它不再是简单的工具,而是能够主动规划和完成复杂任务的智能体。从1997年击败国际象棋世界冠军的IBM“深蓝”,到2011年苹果推出的个人助理Siri,都展示了Agent在特定领域的强大能力,关键的转折点发生在2023年左右,大语言模型LLM的出现为Agent提供了强大的通用理解和推理能力,使其不再局限于单一任务。
Function Calling:函数调用,是LLM的一种能力,允许模型根据用户输入决定何时以及如何调用哪个函数(Tool),并以结构化格式(如JSON)输出函数调用参数。然后由外部系统执行该函数。RAG(检索增强生成):通过从外部知识库检索相关信息,并将其作为上下文提供给LLM,从而生成更准确、更相关的回答。MCP(模型上下文协议):MCP可以包含本地tools和外部API,但通常 MCP更强调于将工具(无论是本地tools还是外部API)以标准化的上下文协议暴露给AI模型。MCP可以看作是一个中间层,它将工具抽象成标准的接口,使得AI Agent可以通过统一的协议来调用这些工具,从而实现模型与工具之间的解耦。
1 | #### main.py |
1 | #### tools.py |
MCP 可以看作是一个中间层,它将工具抽象成标准的接口,使得AI Agent可以通过统一的协议来调用这些工具,从而实现模型与工具之间的解耦。MCP 可以包含本地tools和外部API,但通常 MCP更强调于将工具(无论是本地tools还是外部API)以标准化的上下文协议暴露给AI模型。
RAG 的核心思想是:在让大模型回答问题之前,先从一个外部的、可随时更新的知识库中检索相关信息,然后将这些“新鲜”信息作为上下文和问题一起交给模型,从而引导模型生成更准确、及时且可追溯的答案。它能有效减少模型“幻觉”(即胡编乱造),让AI应用在知识密集型任务中变得真正可靠。以及,它能帮助构建专业领域专家对话机器人。
一个典型的RAG系统工作流程包含三个关键阶段:

业务逻辑
LangChain 是一个功能强大的大语言模型应用开发框架。与Spring在Java后端开发中的定位类似。
https://python.langchain.com/docs/concepts/
https://arxiv.org/abs/2302.07842
LangChain 包:通过 pip 命令(类似于Java的Maven或Gradle)安装到项目中,避免重复造轮子。
LangGraph 核心认知:用“有向图”构建智能体的新一代框架,是 用于构建有状态、多步骤、多分支智能体(Agent) 的框架,核心是将 Agent 的行为拆解为节点(Nodes) 和边(Edges),用有向图(Directed Graph) 替代老版本的“线性循环” 以支持更复杂的流程编排。
LangGraph 可以理解为:给 Agent 设计“流程图”的工具,而老版本 ReAct Agent 只是这个流程图中最基础的“单循环分支”。
https://docs.langchain.com/oss/python/langgraph/overview
1 | { |
InMemorySaver),支持中断、恢复、回溯(比如多轮对话的上下文保留)。cmdb_search、cmdb_query)。用户输入清洗节点 → LLM 思考节点 → CMDB 工具节点 → 日志工具节点 → 回答格式化节点cmdb_search 节点;如果输出“需要调用日志工具”,则跳转到 log_search 节点;如果输出“无需调用工具”,则跳转到“回答节点”。InMemorySaver 就是内存级的检查点,还可以用 Redis、SQL 实现持久化)。1 | [入口节点:用户输入] |
cmdb_search),LangGraph 只通过工具调用节点统一管理,支持多工具的动态选择和调用。cmdb_search,再调用 cmdb_query 统计)。AgentExecutor)是 LangGraph 的简化版,两者的核心差异在于流程的编排能力:| 维度 | 老版本 ReAct Agent(AgentExecutor) | LangGraph |
|---|---|---|
| 架构基础 | 线性循环(Single Loop) | 有向图(Directed Graph) |
| 节点/边 | 无物理节点拆分,只有“思考→工具”的逻辑两步;无多分支边,只有单一循环。 | 支持多节点、多类型边(条件边、普通边),可编排复杂流程。 |
| 状态管理 | 临时状态(每次循环重新生成,无持久化) | 统一的状态对象,支持持久化、回溯(Checkpoint)。 |
| 流程灵活性 | 只能“思考→工具→思考”的单一循环,多工具需按顺序调用(一次一个)。 | 支持多分支(比如不同工具的并行调用)、条件跳转、中断恢复。 |
| 扩展性 | 扩展复杂流程(如多工具并行)需要大量自定义代码。 | 通过图的编排即可实现,无需修改核心逻辑。 |
老版本 ReAct Agent 的核心是 AgentExecutor 的单一循环: |
1 | while True: |
cmdb_search,再调用 alert_search,通过多次循环实现。集成到Java
MongoDB 是一个基于文档的开源 NoSQL 数据库,使用类似 JSON 的文档模型灵活存储数据,旨在为 WEB 应用提供可扩展的高性能数据存储解决方案。
MongoDB 是一个介于关系数据库和非关系数据库之间的产品,是非关系数据库当中功能最丰富,最像关系数据库的。
https://www.mongodb.com/zh-cn/docs/manual/crud/
| MongoDB 概念 | 类比 MySQL 概念 | 类比 Elasticsearch 概念 | 核心解析 |
|---|---|---|---|
| 文档 (Document) | 行 (Row) | 文档 (Document) | 数据的基本单元,是一个键值对的有序集合。它类似于一条完整的记录。 |
| 集合 (Collection) | 表 (Table) | 索引 (Index) | 一组文档的容器。它类似于一张数据表。 |
| 数据库 (Database) | 数据库 (Database) | 无直接对应(可类比为索引的逻辑分组) | 最高层的命名空间,用于组织和管理多个集合。一个 MongoDB 实例可以运行多个数据库,每个数据库在文件系统上有独立的文件。 |
| 字段 (Field) | 列 (Column) | 字段 (Field) | 文档中的键值对,代表一个数据属性。 |
ALTER TABLE 操作。| 特性 | MongoDB | MySQL | Elasticsearch |
|---|---|---|---|
| 数据模型 | 文档模型,动态模式 | 关系模型,固定模式 | 文档模型,可定义映射 |
| 查询语言 | 面向对象的 API 方法 | 标准 SQL 语句 | JSON-based DSL |
| 核心优势 | 敏捷开发、水平扩展、存储复杂数据结构 | 复杂查询、事务一致性、数据完整性 | 全文搜索、日志分析、复杂聚合 |
| 典型场景 | 内容管理系统、用户画像、实时分析、物联网 | 金融交易系统、ERP、CRM等需要严格事务的系统 | 搜索引擎、日志和指标分析、应用内搜索 |
| 操作类型 | 方法示例 | 功能说明 |
|---|---|---|
| 创建 (Create) | db.hosts.insertOne({hostname: "web-01", ip: "192.168.1.100"}) |
向集合中插入一条新文档。若集合不存在,会自动创建。 |
| 批量创建 | db.hosts.insertMany([{hostname: "web-01"}, {hostname: "db-01"}]) |
批量插入多条文档。 |
| 查询 (Read) | db.hosts.find({status: "running"}) |
查询所有符合条件的文档。不传参数则返回所有文档。 |
| 条件查询 | db.hosts.find({"specs.memory": {$gte: 8}}, {hostname: 1, _id: 0}) |
使用查询操作符进行过滤,并使用投影选择返回的字段。 |
| 更新 (Update) | db.hosts.updateOne({hostname: "web-01"}, {$set: {"specs.memory": 32}}) |
更新一条匹配的文档。$set 操作符用于修改特定字段的值。 |
| 批量更新 | db.hosts.updateMany({environment: "production"}, {$inc: {visits: 1}}) |
更新所有匹配的文档。$inc 操作符用于将字段的值增加指定数额。 |
| 删除 (Delete) | db.hosts.deleteOne({hostname: "web-01"}) |
删除一条匹配的文档。 |
| 批量删除 | db.hosts.deleteMany({status: "terminated"}) |
删除所有匹配的文档。 |
insertMany 这样的多文档操作,默认情况下并非一个整体事务。$gt (大于), $gte (大于等于), $lt (小于), $lte (小于等于), $ne (不等于)。$and, $or, $in (匹配数组中任意值), $nin (不匹配数组中任何值)。1 | // 创建 |
1 | // 查询与投影 |
1 | // 更新操作符 |
1 | // 逻辑组合查询 |
1 | // 数组查询 |
1 | // 正则表达式与文本搜索 |
1 | // 场景:找出所有生产环境的Linux主机 |
1 | // 场景:找出内存大于8G的生产环境主机,按内存降序排列,只显示主机名和内存 |
1 | // 目标:查询生产环境的应用,并获取其运行主机的详细信息 |
1 | // 应用文档示例 |
1 | db.hosts.aggregate([ |
1 | db.applications.aggregate([ |
db.hosts.createIndex({ hostname: 1 })db.hosts.createIndex({ environment: 1, status: 1 }) db.hosts.createIndex({ tags: 1 })db.hosts.createIndex({ description: "text" })db.logs.createIndex({ createdAt: 1 }, { expireAfterSeconds: 3600 })1 | Primary(主节点)← 读写操作 |
1 | // 复制集配置 |
1 | // 强一致性写操作 |
1 | // 好的分片键:基数高、分布均匀 |
1 | 自然语言查询 → MCP Server → 查询解析器 → MongoDB查询生成器 → 结果格式化 |
1 | from mcp import MCPServer, Context |
1 | 你是一个CMDB专家,可以查询和分析基础设施信息。 |
1 | # 支持复杂查询的扩展工具 |
Docker 是一种开源平台,一种快速构建、运行和管理应用的工具。它使用容器化技术,使得应用程序及其依赖性可以打包到一个容器中,并在任何支持 Docker 的环境中运行。
1 MobarXterm 通过 SSH 连接 linux虚拟机,操作虚拟机上的 Docker。
2 Windows本地:通过wsl安装Linux发行版本,安装docker desktop(将自动在WSL中配置Docker环境,借助linux内核运行)
1 | docker run -d \ # 创建并运行一个容器,-d 是让容器在后台运行;同一个镜像可创建多个容器 |
1 | docker images # 查看本地镜像 |
镜像结构:入口,层,基础镜像。分层的好处是可复用,,
docker build 命令构建镜像。(如java项目还需要jar包)docker run 命令基于构建的镜像创建和运行容器。1 | docker volumels # 查看数据卷 |
容器编排是指在生产环境中管理和协调多个容器的过程。Docker 提供了 Docker Compose 工具,用于定义和运行多容器的应用。
Kubernetes是一个开源的容器编排引擎,可以用来管理容器化的应用,包括容器的自动化的部署、扩容、缩容、升级、回滚等等;
它是Google在2014年开源的一个项目,它的前身是Google内部的Borg系统。
在Kubernetes出现之前,我们一般都是使用Docker来管理容器化的应用,但是Docker只是一个单机的容器管理工具,它只能管理单个节点上的容器,当我们的应用程序需要运行在多个节点上的时候,就需要使用一些其他的工具来管理这些节点,比如Docker Swarm、Mesos、Kubernetes等等;
这些工具都是容器编排引擎,它们可以用来管理多个节点上的容器,但是它们之间也有一些区别,比如Docker Swarm是Docker官方提供的一个容器编排引擎,它的功能比较简单,适合于一些小型的、简单的场景,而Mesos和Kubernetes则是比较复杂的容器编排引擎;
Mesos是Apache基金会的一个开源项目,而Kubernetes是Google在2014年开源的,目前已经成为了CNCF(Cloud Native Computing Foundation)的一个顶级项目,基本上已经成为了容器编排引擎的事实标准了。

Node:k8s集群节点,可以是物理机/虚拟机
Pod:k8s最小调度单元,容器(运行app/数据库/..镜像)的抽象,可以是一/多个容器的组合,但除非高度耦合,一个pod只运行一个容器
Service:将一组pod封装成一个服务并且提供统一访问入口(解决了一组数据库pod中一个重建后ip变化的问题,类似于“服务发现”)
Ingress:为了对外提供服务,将外部请求路由转发到内部集群的service上
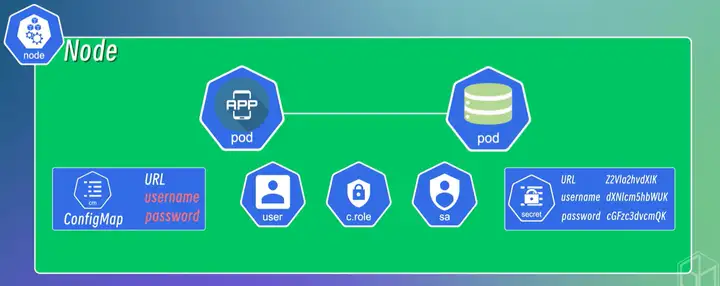
ConfigMap:封装配置信息
Secret:封装敏感信息
其他安全机制:网络安全,访问控制,身份认证
Volumn:将数据挂在到本地磁盘或远程存储上,实现持久化存储
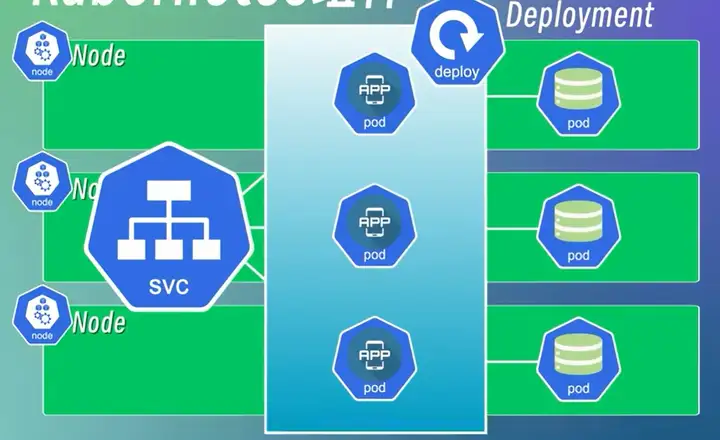
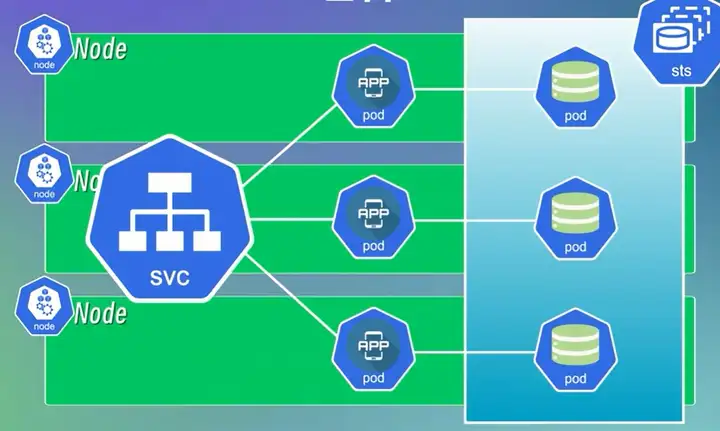
Deployment:部署无状态应用程序,将一/多个Pod组合到一起;冗余备份,相当于对Pod的抽象;具有副本控制、滚动更新、自动扩缩容等功能,实现应用程序的高可用
Statefulset:部署有状态应用程序,如DB、MQ、缓存以及保留会话状态的应用程序
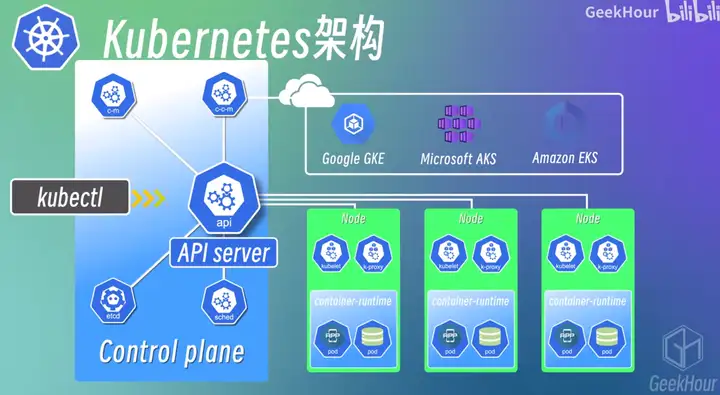
分为Master和Worker节点
apiserver:位于master节点上,是k8s集群的API接口;交互方式包括 kubectl 命令行、Dashboard界面或API接口
pv
pvc
lvm
service
ingress
集群间dns
外部访问
1 | # 查看帮助 |
1 | # 创建并运行一个指定的镜像 |
1 | # 查看集群中某一类型的资源 |
1 | # 更新某个资源的标签 |
1 | # 进入某个Pod的容器中 |
Portainer 是一个轻量级的容器管理工具,可以用来管理Docker和Kubernetes,它提供了一个Web界面来方便我们管理容器
官方网址: https://www.portainer.io/
Helm 是一个Kubernetes的包管理工具,可以用来管理Kubernetes的应用,它提供了一个命令行工具来方便我们管理Kubernetes的应用
官方网址: https://helm.sh/
https://kubernetes.io/zh-cn/docs/concepts/storage/persistent-volumes/
InfluxDB 是一个由InfluxData开发的开源时序型数据库,专注于海量时序数据的高性能读、高性能写、高效存储与实时分析等;
在DB-Engines Ranking时序型数据库排行榜上排名第一,广泛应用于DevOps监控、IoT监控、实时分析等场景。
https://jasper-zhang1.gitbooks.io/influxdb/content/Introduction/getting_start.html
influxdb-cluster 是InfluxDB的集群版本,InfluxDB Enterprise 的开源替代方案,设计用于大规模数据存储和高可用性需求。
可以实现数据的分片和复制,从而提高系统的可用性和扩展性。数据安全。operator缺失
https://github.com/chengshiwen/influxdb-cluster/wiki
InfluxDB Enterprise由两组软件进程组成: Data 数据节点 和 Meta 元节点。集群内的通信是这样的:
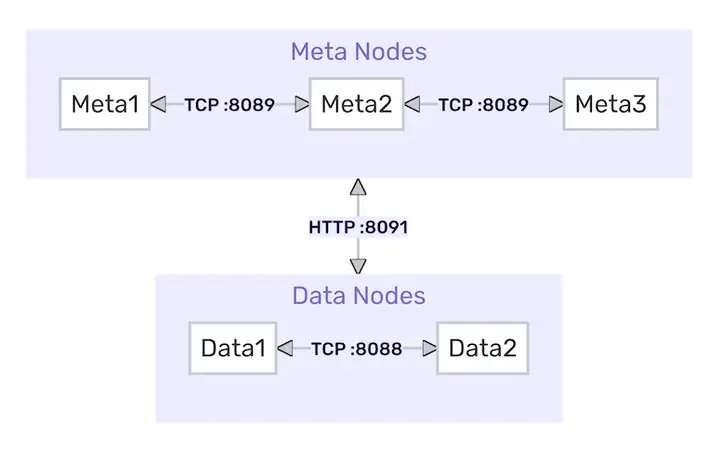
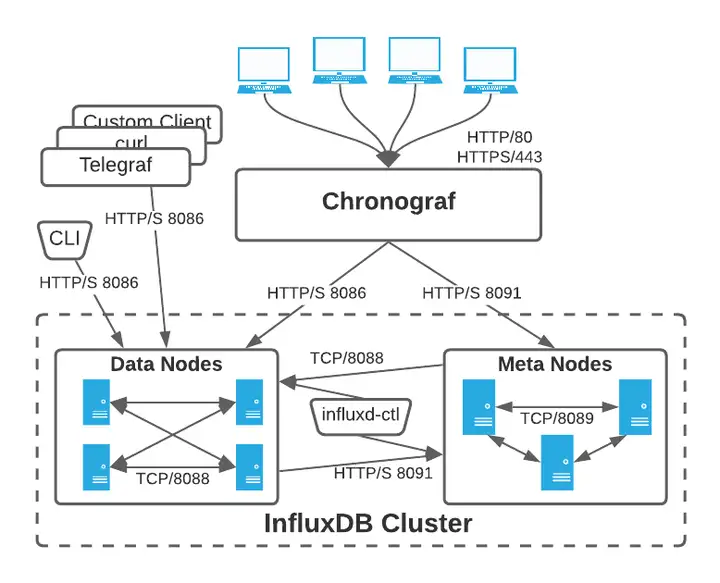
influxdb使用的默认端口号为分别为用于meta集群内部服务的8091端口,meta节点通信的8089端口,data集群内部服务的8088端口,以及data节点对外提供http服务的8086端
InfluxDB 集群中,一个节点要么是专门用于存储和查询时间序列数据的数据节点,要么是专门用于存储集群元数据的元节点。数据节点负责存储实际的数据和处理查询请求,而元节点则负责管理集群的元数据,包括节点信息、数据库和保留策略等。
元节点保存以下所有元数据:
元节点将这些数据保存在磁盘上的Raft数据库中,由BoltDB提供支持。默认情况下,Raft数据库是/var/lib/influxdb/meta/raft.db。
注意:Meta节点需要/ Meta目录。
influxd-meta 元数据服务1 | # 配置文件示例(meta节点) |
influxd-ctl 集群管理1 | # 查看分片分布 |
数据节点保存所有原始时间序列数据和元数据,包括:
在磁盘上,数据总是按照
influx CLI工具1 | # 进入容器执行CLI |
influxd 数据节点服务1 | # 查看运行状态 |
influx_inspect 数据工具1 | # 导出TSM文件(需进入容器) |
通信协议
| 组件 | 端口 | 用途 | 协议 |
|---|---|---|---|
| Meta节点间 | 8089 | Raft协议同步元数据 | TCP |
| Data节点间 | 8088 | 分片数据复制 | TCP |
| Data→Meta节点 | 8091 | 注册节点/获取分片元信息 | HTTP |
核心交互场景
节点注册 : Data节点启动时通过HTTP API向Meta节点注册(POST /data)
分片分配 : Meta节点根据replication-factor策略分配分片到Data节点
写入协调 : 客户端写入数据时,由Meta节点确定目标分片所在Data节点
故障转移 : Meta节点检测Data节点离线后,自动通过Hinted Handoff机制转移副本
一个集群至少要有三个独立的元节点才能允许一个节点的丢失,如果要容忍n个节点的丢失则需要2n+1个元节点。集群的元节点的数目应该为奇数。不要是偶数元节点,因为这样在特定的配置下会导致故障。
一个集群运行只有一个数据节点,但这样数据就没有冗余了。这里的冗余通过写数据的RP中的副本个数来设置。一个集群在丢失n-1个数据节点后仍然能返回完整的数据,其中n是副本个数。为了在集群内实现最佳数据分配,我们建议数据节点的个数为偶数。
1 | $ influx -precision rfc3339 |
1 | <measurement>[,<tag-key>=<tag-value>...] <field-key>=<field-value>[,<field2-key>=<field2-value>...] [unix-nano-timestamp] |
1 | > use testdb |
1 | > SELECT "host", "region", "value" FROM "cpu" |
1 | curl -i -XPOST 'http://localhost:8086/write?db=mydb' --data-binary 'cpu_load_short,host=server01,region=us-west value=0.64 1434055562000000000' |
1 | curl -G 'http://localhost:8086/query?pretty=true' --data-urlencode "db=mydb" --data-urlencode "q=SELECT \"value\" FROM \"cpu_load_short\" WHERE \"region\"='us-west'" |
shard := shardGroup.shards[fnv.New64a(key) % len(shardGroup.Shards)]
4/2=2 个分片(Shard 1 & 2)cpu,host=svr1 usage=80:Series Key = cpu,host=svr1,哈希值模2=1 ⇒ 分片2,数据同时写入节点 C 和 DSELECT * FROM cpu WHERE time > '2025-04-02':定位到 2025-04-02 分片组, 协调节点同时向 A/B(分片1)和 C/D(分片2)发起查询, 合并结果后返回Docker安装操作单例InfluxDB https://www.cnblogs.com/nhdlb/p/16409849.html
Docker快速开始集群InfluxDB https://github.com/chengshiwen/influxdb-cluster/wiki#docker-%E5%BF%AB%E9%80%9F%E5%BC%80%E5%A7%8B
在使用容器多节点部署InfluxDB时,数据库、容器、Docker、主机和Kubernetes(k8s)之间的关系可以理解如下:
Kubernetes 存储与 InfluxDB Shard 的关系解析
/var/lib/influxdb/data 目录下。/var/lib/influxdb/data/<database>/<retention_policy>/<shard_id>。Delete(默认),删除 PVC 会导致 Kubernetes 清理其绑定的 PV 及底层存储数据(如 NFS 目录、云盘等)。此时 /var/lib/influxdb 下的 data、meta 目录被清空,导致 Shard 文件丢失。ERR: shard not found 错误。https://docs.influxdata.com/enterprise_influxdb/v1/administration/backup-and-restore/
https://blog.csdn.net/weixin_46560589/article/details/127748939
InfluxDB Enterprise支持在集群实例、单个数据库和保留策略以及单个分片中备份和恢复数据。
1 | influxd backup -portable /path/to/backup |
1 | influxd backup -portable -database <database_name> /path/to/backup |
1 | influxd backup -portable -start <timestamp> /path/to/backup |
备份的数据可以恢复到新实例或现有实例中。
1 | influxd restore -portable /path/to/backup |
1 | influxd restore -portable -db <database_name> /path/to/backup |
-newdb 选项来实现:1 | influxd restore -portable -db <old_database_name> -newdb <new_database_name> /path/to/backup |
对于大多数InfluxDB Enterprise应用程序,备份和恢复实用程序提供了备份和恢复策略所需的工具。但是,在某些情况下,标准备份和恢复实用程序可能无法充分处理应用程序中的大量数据。作为标准备份和恢复实用程序的替代方案,可以使用InfluxDB influx_inspect export和涌入-import命令为灾难恢复和备份策略创建备份和恢复过程。
1 | root@influxdb-e2cb6c913a191e56c134e-data-0:/# influx_inspect export -datadir "/var/lib/influxdb/data" -waldir "/var/lib/influxdb/wal" -out "influxdb_test01_dump_out" -database "test01" -start "2024-10-22T00:00:00Z" |
1 | root@influxdb-e73f149ff7192bd87d190-data-1:/# influx -import -path='influxdb_test01_dump_out' -precision=ns -username='' -password='' |
-database,加 -compress-compressed 导入压缩文件,本质上是先解压后倒入Data节点迁移方案评审:先迁移后逐个恢复分片数据。已验证在分片副本大小70M、写入数据达2000point/s的情况下直接copy-shard会导致增量数据丢失,考虑在copy-shard前先执行truncate-shards截断热分片(集群中所有写入最新数据的分片,截断后关闭写入,变成冷分片),并在所有Data节点上创建该分片的新热分片副本,也就是在迁移节点上恢复了全部原有分片的新热分片副本,最新数据写入这个副本,然后再逐个从健康节点上的冷分片副本copy-shard恢复出分片的历史数据(迁移前分片副本原有的数据&迁移过程中未能写入的数据),该分片数据完全恢复;自测符合预期
1 | kubectl exec -i influxdb-xx-meta-0 -n influxdb -- influxd-ctl show-shards # 或influx命令行执行show shards |
1 | kubectl exec -i influxdb-xx-meta-0 -n influxdb -- influxd-ctl remove-data influxdb-xx-data-0.influxdb-xx-data:8088 |
1 | kubectl exec -i influxdb-xx-meta-0 -n influxdb -- influxd-ctl truncate-shards |
1 | # 对于_internal分片的转移 先copy后remove |
1 | # 分片的物理文件 wal&tsm |
1 | # 可能要等wal落tsm |